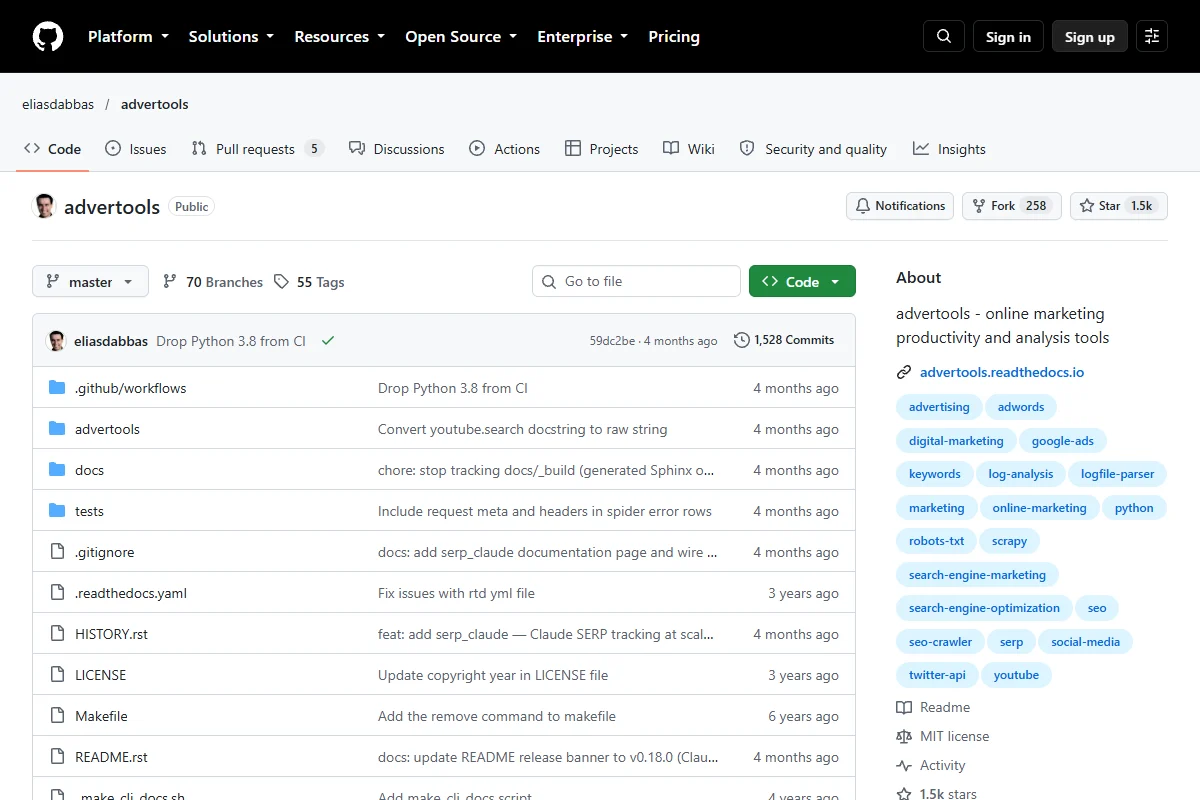
Tải mã nguồn Advertools trên GitHub
Trong kỷ nguyên SEO dựa trên dữ liệu (Data-Driven SEO), việc phụ thuộc hoàn toàn vào các giao diện đồ họa (GUI) của các công cụ trả phí như Screaming Frog, Ahrefs hay SEMrush thường bộc lộ những giới hạn rõ rệt khi đối mặt với các dự án lớn: chi phí bản quyền cao, hạn chế khả năng tùy biến luồng dữ liệu, và khó khăn trong việc nhúng trực tiếp vào đường ống phân tích tự động (Data Pipeline). Để giải quyết bài toán này, Advertools ra đời như một giải pháp cứu cánh mạnh mẽ. Được phát triển bởi chuyên gia kỹ thuật dữ liệu và tiếp thị số Elias Dabbas, Advertools là thư viện Python chuyên biệt nhằm nâng cao năng suất cho các chuyên gia Technical SEO và Search Engine Marketing (SEM) thông qua việc kết hợp chặt chẽ với hệ sinh thái phân tích dữ liệu hàng đầu.
Đối với các kỹ sư SEO hiện đại, việc trang bị kỹ năng lập trình xử lý tự động hóa là một bước tiến mang tính bước ngoặt. Nếu bạn đang muốn nâng cấp nền tảng kiến thức từ SEO truyền thống lên các kỹ thuật tự động hóa chuyên sâu, bạn có thể tham khảo thêm tại khóa học SEO miễn phí để nắm vững tư duy ứng dụng dữ liệu thực chiến vào quy trình tối ưu hóa website.
Giải thích nguyên lý hoạt động của Advertools
Advertools hoạt động dựa trên triết lý tối giản hóa các tác vụ trích xuất và biến đổi dữ liệu tiếp thị số, chuyển toàn bộ dữ liệu phức tạp trên web thành các cấu trúc bảng tiêu chuẩn trong Pandas DataFrame. Nhờ thiết kế này, mọi kết quả trả về từ Advertools đều sẵn sàng để lọc, tính toán, vẽ biểu đồ trực quan hoặc xuất sang các định dạng như CSV, Parquet, SQLite hay BigQuery chỉ trong một vài dòng mã.
Nguyên lý vận hành của Advertools tập trung vào 4 trụ cột kỹ thuật then chốt:
- Tích hợp toàn diện với Pandas DataFrame: Hầu hết mọi hàm trong Advertools (như
sitemap_to_df,url_to_df,robotstxt_to_df) đều trả về trực tiếp một đối tượng DataFrame. Điều này cho phép tận dụng triệt để sức mạnh xử lý vector hóa (vectorized operations) của Pandas, giúp việc thao tác trên hàng trăm nghìn dòng dữ liệu URL diễn ra chỉ trong vài giây. - Phân tích sâu cấu trúc URL (URL Parsing & Decomposition): Module
adv.url_to_df()sử dụng chuẩn phân tích RFC 3986, bóc tách triệt để từng thành phần của liên kết: scheme, netloc, path, query parameters, fragment, và các nấc thư mục (directory depth). Nhờ đó, việc đánh giá độ sâu của cấu trúc website (site architecture depth) và phát hiện các biến thể query parameter gây trùng lặp nội dung trở nên cực kỳ chính xác. - Phân tích cú pháp tệp robots.txt theo chuẩn RFC 9309: Advertools tích hợp trình phân tích chuyên sâu cho các chỉ thị User-agent, Disallow, Allow, Crawl-delay và Sitemap. Không dừng lại ở việc đọc file, module
robotstxt_test()còn mô phỏng cơ chế kiểm tra quyền thu thập dữ liệu của từng bot tìm kiếm cụ thể (Googlebot, Bingbot, Yandex…) trên từng URL định tuyến. - Đọc và crawl XML sitemap bất đồng bộ siêu tốc: Khác với các thư viện thông thường gửi request tuần tự, Advertools triển khai các thư viện HTTP bất đồng bộ để đọc song song hàng loạt file sitemap con trong Sitemap Index, hỗ trợ giải nén trực tiếp định dạng gzip (
.xml.gz) ngay trong bộ nhớ (in-memory) mà không cần ghi tệp tạm ra ổ cứng.
Yêu cầu hệ thống và môi trường thực thi
Để triển khai Advertools đạt hiệu suất tối đa, đặc biệt là khi thu thập dữ liệu hàng triệu URL, hệ thống của bạn cần đáp ứng các tiêu chuẩn sau:
- Python Version: Python 3.8 trở lên (Khuyến nghị sử dụng Python 3.10 hoặc 3.11 để tận dụng các cải tiến hiệu năng về xử lý luồng và quản lý bộ nhớ).
- Môi trường lập trình (IDE):
- Jupyter Notebook / JupyterLab: Môi trường lý tưởng nhất cho việc khám phá dữ liệu (EDA), phân tích ad-hoc và hiển thị bảng biểu trực quan.
- Visual Studio Code (VS Code) / PyCharm: Phù hợp cho việc xây dựng các script tự động hóa, pipeline ETL hoặc tích hợp vào hệ thống CI/CD để kiểm thử SEO định kỳ.
- Thư viện phụ thuộc cốt lõi:
pandas: Nền tảng cấu trúc dữ liệu dạng bảng.scrapy: Được tích hợp bên dưới moduleadv.crawl()để cung cấp khả năng cào dữ liệu song song cực kỳ mạnh mẽ.pyarrow: Thư viện định dạng bộ nhớ dạng cột, rất quan trọng khi bạn muốn đọc/ghi các file kết quả crawl siêu lớn dưới dạng file Parquet hoặc tối ưu hóa kiểu dữ liệu string trong Pandas 2.0+.
Hướng dẫn cài đặt Advertools thủ công
Việc cài đặt Advertools rất đơn giản thông qua trình quản lý gói pip. Khuyến nghị bạn nên khởi tạo một môi trường ảo (virtual environment) riêng biệt để tránh xung đột các phiên bản thư viện khác trong hệ thống.
Mở terminal hoặc command prompt và thực thi các câu lệnh sau:
# Tạo môi trường ảo tên là 'seo_env'
python -m venv seo_env

# Kích hoạt môi trường ảo
# Trên Windows:
seo_env\Scripts\activate
# Trên macOS/Linux:
source seo_env/bin/activate

# Nâng cấp pip lên phiên bản mới nhất
pip install --upgrade pip

# Cài đặt advertools cùng các gói hỗ trợ tối ưu hiệu năng
pip install advertools pandas pyarrow jupyter
Sau khi quá trình cài đặt hoàn tất, bạn có thể kiểm tra xem thư viện đã được cài đặt thành công hay chưa bằng cách mở Python interactive shell:
import advertools as adv
print(adv.__version__)
Các module cốt lõi cho Technical SEO
Phân tích và kiểm tra robots.txt với robotstxt_test()
Quản lý tệp robots.txt là một trong những nhiệm vụ cốt lõi của Technical SEO. Chỉ một sai sót nhỏ trong biểu thức chính quy hoặc thứ tự ưu tiên của chỉ thị Disallow có thể khiến toàn bộ phân mục quan trọng bị chặn lập chỉ mục (de-indexed). Advertools cung cấp hai hàm mạnh mẽ là robotstxt_to_df() để tải toàn bộ tệp về dạng bảng và robotstxt_test() để kiểm tra quyền truy cập của bot.
import advertools as adv

# 1. Chuyển đổi toàn bộ cấu trúc robots.txt thành DataFrame để audit quy mô lớn
robots_url = "https://example.com/robots.txt"
df_robots = adv.robotstxt_to_df(robots_url)
print(df_robots.head(10))

# 2. Kiểm tra quyền truy cập cụ thể của Googlebot đối với danh sách URL cần test
urls_to_check = [
    "https://example.com/san-pham/dien-thoai",
    "https://example.com/admin/login",
    "https://example.com/search?q=iphone",
    "https://example.com/wp-admin/"
]

test_results = adv.robotstxt_test(
    robotstxt_url=robots_url,
    target_urls=urls_to_check,
    user_agents=['Googlebot', 'Bingbot', '*']
)

# Kết quả trả về bảng chi tiết URL nào được Allow hoặc Block
print(test_results[['user_agent', 'url_path', 'can_fetch']])
Hàm robotstxt_test() tự động tuân thủ chặt chẽ đặc tả kỹ thuật Google Robots Exclusion Protocol, giúp bạn tự động hóa việc kiểm tra trước khi triển khai thay đổi tệp robots.txt lên máy chủ staging hoặc production.
Cào và giải mã XML Sitemap với sitemap_to_df()
Một XML sitemap lớn thường chứa hàng chục tệp con (Sitemap Index) với hàng chục nghìn liên kết. Phân tích thủ công là điều bất khả thi. Với hàm sitemap_to_df(), Advertools tự động đệ quy duyệt qua tất cả các sitemap con, tải xuống dữ liệu song song và bóc tách đầy đủ các thẻ: loc, lastmod, changefreq, priority, cũng như các thành phần image sitemap, video sitemap hay tin tức.
import advertools as adv
import pandas as pd

# Tải và giải mã toàn bộ Sitemap Index
sitemap_index_url = "https://example.com/sitemap_index.xml"
df_sitemap = adv.sitemap_to_df(sitemap_index_url)

# Thống kê tổng số lượng URL tìm thấy
print(f"Tổng số URL: {len(df_sitemap)}")

# Chuyển đổi cột lastmod sang định dạng datetime chuẩn để phân tích tần suất cập nhật
df_sitemap['lastmod'] = pd.to_datetime(df_sitemap['lastmod'])

# Lọc các bài viết không được cập nhật trong hơn 365 ngày qua
stale_articles = df_sitemap[df_sitemap['lastmod'] < pd.Timestamp.now(tz='UTC') - pd.Timedelta(days=365)]
print(f"Số lượng bài viết cũ cần cập nhật hoặc audit nội dung: {len(stale_articles)}")
Bằng cách chuyển sitemap thành DataFrame, bạn có thể dễ dàng so sánh danh sách URL trong sitemap với danh sách URL được index trên Google Search Console hoặc log file của server để phát hiện hiện tượng "Zombie Pages" hoặc trang mồ côi (Orphan Pages).
Audit toàn diện website bằng module adv.crawl()
Thay vì sử dụng các phần mềm desktop cồng kềnh, Advertools cung cấp hàm crawl() được xây dựng trực tiếp trên kiến trúc phân tán của framework Scrapy trứ danh. Hàm này lưu trữ toàn bộ dữ liệu thu thập được theo định dạng JSON Lines (.jl), cho phép xử lý luồng dữ liệu liên tục mà không gây quá tải RAM, ngay cả khi cào các website hàng trăm nghìn trang.
import advertools as adv

# Thiết lập đường dẫn lưu kết quả và các thông số crawler
output_file = 'website_audit_results.jl'

# Khởi chạy quá trình crawl bất đồng bộ
adv.crawl(
    url_list='https://example.com',
    output_file=output_file,
    follow_links=True,
    custom_settings={
        'USER_AGENT': 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)',
        'CONCURRENT_REQUESTS': 16,
        'DOWNLOAD_DELAY': 0.25,
        'CLOSESPIDER_PAGECOUNT': 5000, # Giới hạn 5000 trang
        'LOG_LEVEL': 'INFO'
    }
)

# Đọc kết quả trực tiếp vào DataFrame để phân tích
df_crawl = pd.read_json(output_file, lines=True)

# Lọc nhanh các trang có mã phản hồi HTTP 404 hoặc 500
broken_pages = df_crawl[df_crawl['status'] >= 400][['url', 'status', 'title']]
print("Danh sách URL bị lỗi:", broken_pages)

# Kiểm tra các trang bị thiếu thẻ H1 hoặc trùng lặp thẻ Title
missing_h1 = df_crawl[df_crawl['h1'].isna()][['url', 'title']]
duplicate_titles = df_crawl[df_crawl.duplicated(subset=['title'], keep=False)][['url', 'title']]
Mọi thuộc tính Onpage quan trọng như độ dài thẻ title, meta description, thẻ canonical, directive robots (noindex/nofollow), OpenGraph tags và cấu trúc liên kết nội bộ (internal links) đều được trích xuất hoàn hảo vào từng cột dữ liệu riêng biệt.
Phân tích tần suất từ khóa & ngram cho Content SEO
Ngoài Technical SEO, Advertools còn cực kỳ mạnh mẽ trong lĩnh vực Content Optimization và SEM với module phân tích văn bản. Module word_frequency() cho phép bạn đếm tần suất xuất hiện của từ đơn hoặc cụm từ ghép (n-gram: bigrams, trigrams) sau khi đã tự động loại bỏ danh sách stop-words.
import advertools as adv

# Giả sử chúng ta có danh sách tiêu đề từ đối thủ cạnh tranh hoặc bài viết trên site
titles = [
    "Dịch vụ SEO tổng thể uy tín chuyên nghiệp",
    "Khóa học SEO miễn phí tại TPHCM cho người mới bắt đầu",
    "Báo giá dịch vụ SEO từ khóa lên top Google",
    "Hướng dẫn tự học SEO website từ cơ bản đến nâng cao"
]

# Phân tích cụm 2 từ (Bigrams) phổ biến nhất
phrase_freq = adv.word_frequency(
    text_list=titles,
    phrase_len=2,
    rm_words=adv.stopwords['vietnamese'] if 'vietnamese' in adv.stopwords else []
)

print(phrase_freq.head(10))
Module này hỗ trợ đắc lực cho các chiến dịch Google Ads (tạo cụm từ khóa kết hợp tự động với kw_generate()) cũng như tối ưu hóa khoảng trống ngữ nghĩa (content gap) cho các bài viết chuẩn SEO.
Kết hợp Advertools và Data Analysis để tự động hóa báo cáo SEO định kỳ
Điểm khác biệt lớn nhất giữa một chuyên viên SEO thông thường và một kỹ sư Technical SEO là khả năng tự động hóa quy trình giám sát. Khi kết hợp Advertools với thư viện lập lịch trình (như schedule hoặc Airflow) cùng các công cụ trực quan hóa (như Matplotlib, Plotly hoặc đẩy vào Looker Studio), bạn có thể xây dựng một hệ thống cảnh báo sớm (Early-warning System) cho sức khỏe website:
- Giám sát thay đổi Sitemap hàng tuần: Viết một script chạy định kỳ vào 2h sáng Chủ Nhật, tự động kéo XML Sitemap, so sánh
lastmodvới tuần trước đó và gửi danh sách các URL mới đăng tải hoặc được cập nhật vào kênh Slack/Telegram của nhóm nội dung. - Kiểm tra trạng thái liên kết chuyển hướng (Redirect Chains): Dùng Advertools bóc tách toàn bộ liên kết nội bộ trong file crawl, quét các chuỗi chuyển hướng 301/302 liên tiếp để giảm hao phí ngân sách thu thập dữ liệu (crawl budget) của Googlebot.
- Tự động hóa kiểm tra tính toàn vẹn của thẻ Canonical: So sánh cột
urlgốc và giá trị trích xuất từcanonicaltrong DataFrame để phát hiện ngay các lỗi tự trỏ canonical sai lệch hoặc xung đột phân trang.
Nếu bạn muốn nắm bắt toàn bộ tư duy phân tích này và cách kết hợp lập trình Python vào chiến lược SEO doanh nghiệp, hãy tham gia khóa học SEO miễn phí để được hướng dẫn chi tiết từ các chuyên gia hàng đầu.
Khắc phục các lỗi thường gặp khi triển khai Advertools
Trong quá trình làm việc thực tế với Advertools trên các tập dữ liệu lớn tại thị trường Việt Nam, bạn có thể đối mặt với một số rào cản kỹ thuật cụ thể. Dưới đây là giải pháp xử lý triệt để:
1. Lỗi mã hóa ký tự (Encoding) với dữ liệu Tiếng Việt
Khi crawl nội dung chứa tiếng Việt có dấu, một số hệ điều hành Windows mặc định sử dụng bảng mã cp1252 hoặc cp1258, dẫn đến hiện tượng chuỗi ký tự bị biến dạng (mojibake) khi ghi hoặc đọc file kết quả .jl.
Giải pháp: Luôn chỉ định rõ ràng encoding utf-8 khi thao tác với file và cấu hình biến môi trường trong script Python:
import sys
import io

# Đảm bảo luồng xuất nhập chuẩn trên Windows luôn dùng UTF-8
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')

# Khi đọc file kết quả JSON Lines bằng Pandas:
df = pd.read_json('results.jl', lines=True, encoding='utf-8')
2. Xử lý tệp Sitemap nén .xml.gz quy mô lớn
Một số website lớn nén sitemap dưới dạng tệp gzip nhưng cấu hình header HTTP trả về không chuẩn hoặc kết nối mạng bị gián đoạn giữa chừng, khiến hàm sitemap_to_df() báo lỗi BadGzipFile hoặc timeout.
Giải pháp: Tận dụng thư viện requests kết hợp gzip và io.BytesIO để tải tệp với cơ chế retry trước khi đưa nội dung vào Advertools:
import requests
import gzip
import io
import advertools as adv

headers = {'User-Agent': 'Mozilla/5.0'}
response = requests.get('https://example.com/sitemap.xml.gz', headers=headers, timeout=30)

if response.status_code == 200:
    with gzip.GzipFile(fileobj=io.BytesIO(response.content)) as gz:
        xml_content = gz.read().decode('utf-8')
        # Lưu ra file tạm hoặc phân tích trực tiếp
        with open('sitemap_decompressed.xml', 'w', encoding='utf-8') as f:
            f.write(xml_content)

    df_sitemap = adv.sitemap_to_df('sitemap_decompressed.xml')
3. Xử lý bài toán Crawl website lớn bị nghẽn RAM và chặn IP
Khi sử dụng adv.crawl() trên các website thương mại điện tử với hàng chục nghìn sản phẩm, hai vấn đề lớn thường phát sinh: crawler ngốn hết dung lượng RAM hệ thống và máy chủ mục tiêu kích hoạt tường lửa (WAF/Cloudflare) chặn IP.
Giải pháp:
- Tối ưu hóa Scrapy Settings: Điều chỉnh
CONCURRENT_REQUESTS_PER_DOMAINở mức vừa phải (từ 4 đến 8) và kích hoạtAUTOTHROTTLE_ENABLED: Trueđể Scrapy tự động điều chỉnh tốc độ gửi request dựa trên tải của máy chủ. - Sử dụng HTTP Proxy xoay vòng: Cấu hình middleware proxy trong phần
custom_settingsđể phân tán lưu lượng request, ngăn chặn việc IP bị khóa tạm thời. - Đọc dữ liệu theo từng Chunk: Thay vì dùng
pd.read_json(..., lines=True)để nạp toàn bộ tệp.jldung lượng vài GB vào RAM, hãy sử dụng cơ chế đọc theo từng phần:# Đọc file kết quả lớn theo từng chunk 10,000 dòng chunk_size = 10000 for chunk in pd.read_json('massive_crawl.jl', lines=True, chunksize=chunk_size): # Lọc và chỉ trích xuất các cột cần thiết trước khi xử lý tiếp filtered_chunk = chunk[chunk['status'] != 200][['url', 'status']] filtered_chunk.to_csv('errors_summary.csv', mode='a', header=False, index=False)
Advertools thực sự là một vũ khí hạng nặng mở ra cánh cửa tự động hóa và phân tích dữ liệu chuyên sâu cho mọi SEOer. Việc làm chủ thư viện này không chỉ giúp bạn giải quyết các bài toán Technical SEO phức tạp trong thời gian ngắn nhất mà còn nâng tầm tư duy kỹ thuật dữ liệu của bạn trong mọi chiến dịch tiếp thị số.