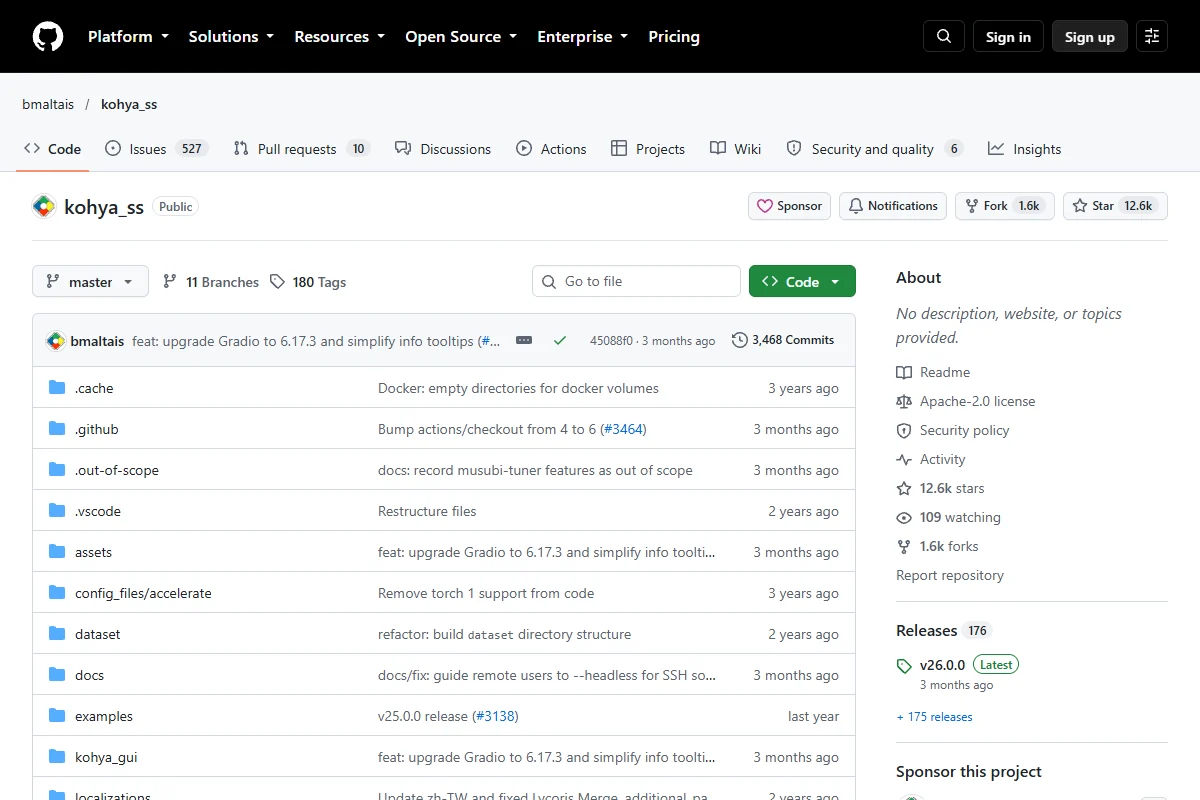
Tải mã nguồn Kohya_ss trên GitHub
Trong kỷ nguyên bùng nổ của trí tuệ nhân tạo tạo sinh hình ảnh, việc tùy biến và huấn luyện (fine-tuning) các mô hình nền tảng như Stable Diffusion (SD 1.5, SDXL, Flux.1) nhằm tạo ra các phong cách nghệ thuật, nhân vật cụ thể hoặc sản phẩm thương mại là nhu cầu sống còn của các nhà phát triển và thiết kế đồ họa chuyên nghiệp. Trong số các công cụ hiện nay, Kohya_ss (phát triển và duy trì bởi bmaltais dựa trên thư viện gốc của Kohya-S) được xem là bộ công cụ GUI và CLI toàn diện, mạnh mẽ và chuẩn mực nhất dành cho việc huấn luyện LoRA (Low-Rank Adaptation) và Dreambooth.
Bài viết này cung cấp hướng dẫn chuyên sâu từ cơ chế toán học nền tảng, thiết lập môi trường tối ưu phần cứng, quy trình tiền xử lý dữ liệu chuẩn SEO và hình ảnh, đến cấu hình siêu tham số (hyperparameters) và kỹ thuật gỡ lỗi phần cứng trên thực tế. Nắm vững kỹ thuật này không chỉ giúp bạn làm chủ quy trình tạo ảnh AI mà còn bổ trợ đắc lực cho việc tối ưu tài nguyên số và đồ họa khi tham gia khóa học SEO miễn phí để xây dựng hệ thống website hiệu năng cao.
1. Nguyên lý hoạt động của Kohya_ss và kỹ thuật LoRA trong Stable Diffusion
Để hiểu rõ cách Kohya_ss vận hành, chúng ta cần phân biệt giữa huấn luyện toàn phần (Full Fine-tuning), Dreambooth truyền thống và LoRA (Low-Rank Adaptation).
Cơ chế suy giảm thứ hạng (Low-Rank Adaptation – LoRA)
Một mô hình khuếch tán tiềm ẩn (Latent Diffusion Model) như Stable Diffusion 1.5 chứa xấp xỉ 1 tỷ tham số (SDXL lên đến 3.5 tỷ tham số). Khi tiến hành tinh chỉnh thông thường, toàn bộ ma trận trọng số $W \in \mathbb{R}^{d \times k}$ của mạng U-Net và Text Encoder phải được cập nhật qua quá trình lan truyền ngược (backpropagation). Quá trình này đòi hỏi dung lượng bộ nhớ VRAM khổng lồ để lưu trữ trọng số, gradients và trạng thái tối ưu hóa (optimizer states).
LoRA giải quyết triệt để bài toán này bằng giả thuyết: sự biến thiên ma trận trọng số trong quá trình thích ứng tác vụ cụ thể có “thứ hạng nội tại” (intrinsic rank) rất thấp. Thay vì cập nhật trực tiếp $\Delta W \in \mathbb{R}^{d \times k}$, LoRA phân rã ma trận này thành tích của hai ma trận có thứ hạng thấp hơn:
\Delta W = B \times A
Trong đó:
- A \in \mathbb{R}^{r \times k} (được khởi tạo theo phân phối chuẩn Gaussian)
- B \in \mathbb{R}^{d \times r} (được khởi tạo bằng 0 để tại bước khởi đầu \Delta W = 0)
- r \ll \min(d, k) là siêu tham số Rank (thường chọn từ 4 đến 128)
Khi đó, trọng số tinh chỉnh được tính bằng: W' = W_0 + \frac{\alpha}{r} (B \times A), với $\alpha$ (Alpha) là hệ số co giãn trọng số. Nhờ phép phân tách này, số lượng tham số cần huấn luyện giảm đi từ 90% đến 99.9%, đưa kích thước tệp mô hình đầu ra từ vài Gigabyte (ckpt/safetensors của full checkpoint) xuống chỉ còn từ 10MB đến 200MB, đồng thời giảm mạnh gánh nặng VRAM.
Kiến trúc điều phối của Kohya_ss
Kohya_ss đóng vai trò là một tầng giao diện tương tác và bộ tự động hóa (wrapper script) cấp cao, đóng gói các thư viện học máy lõi:
- HuggingFace Accelerate: Điều phối tính toán đa luồng, quản lý song song dữ liệu và tích hợp bộ nhớ hỗn hợp FP16/BF16.
- PyTorch & CUDA Toolkit: Nền tảng tính toán tensor trực tiếp trên GPU Nvidia.
- BitsandBytes: Cung cấp các bộ tối ưu hóa lượng tử hóa 8-bit (AdamW8bit, Lion8bit, Prodigy), cắt giảm đáng kể VRAM cho Optimizer States.
- Giao diện Gradio: Cung cấp bảng điều khiển trực quan trên nền web, cho phép người dùng cấu hình hơn 100 siêu tham số mà không cần chỉnh sửa mã lệnh thủ công trong terminal.
2. Yêu cầu hệ thống và môi trường thực thi
Huấn luyện mạng nơ-ron là tác vụ đòi hỏi khắt khe về băng thông bộ nhớ và năng lực tính toán dấu phẩy động. Bảng dưới đây mô tả chi tiết thông số kỹ thuật tối thiểu và khuyến nghị:
| Thành phần phần cứng / phần mềm | Cấu hình tối thiểu (SD 1.5 LoRA) | Cấu hình khuyến nghị (SDXL / Dreambooth) |
|---|---|---|
| GPU (Card đồ họa) | NVIDIA RTX 2060/3060 (VRAM 6GB – 8GB) | NVIDIA RTX 3090 / RTX 4090 (VRAM 24GB) |
| Hệ điều hành | Windows 10/11 64-bit hoặc Ubuntu 20.04+ | Ubuntu 22.04 LTS / WSL2 trên Windows 11 |
| Python | Python 3.10.x (khuyến nghị 3.10.9 – 3.10.11) | Python 3.10.11 |
| RAM hệ thống | 16 GB DDR4 | 32 GB – 64 GB DDR4/DDR5 |
| Ổ cứng lưu trữ | SSD SATA 50 GB trống | NVMe M.2 SSD PCIe Gen4 (tối thiểu 100 GB trống) |
| CUDA Toolkit & cuDNN | CUDA 11.8 | CUDA 12.1 hoặc 12.4 đi kèm cuDNN 8.9+ |
Lưu ý đặc biệt: GPU của hãng AMD hoặc Intel Arc hiện chỉ hỗ trợ thông qua ROCm hoặc DirectML, tuy nhiên độ ổn định kém hơn rất nhiều và khó tương thích với bộ tối ưu hóa Bitsandbytes. Đối với môi trường sản xuất công nghiệp, GPU kiến trúc NVIDIA Ampere/Ada Lovelace là lựa chọn bắt buộc.
3. Hướng dẫn cài đặt Kohya_ss thủ công từng bước
Để đảm bảo không bị xung đột môi trường Python toàn cục, quy trình chuẩn luôn là khởi tạo môi trường ảo (Virtual Environment). Dưới đây là các lệnh cài đặt chi tiết trên Windows PowerShell hoặc Linux Bash.
Bước 1: Chuẩn bị môi trường Git và Python 3.10
Hãy chắc chắn rằng Git và Python 3.10 đã được thêm vào biến môi trường hệ thống (System PATH). Kiểm tra phiên bản bằng lệnh:
git --version
python --version
Bước 2: Clone repository từ GitHub và tạo Virtual Environment
# 1. Clone repository chính thức của Kohya_ss
git clone https://github.com/bmaltais/kohya_ss.git
cd kohya_ss

# 2. Khởi tạo môi trường ảo venv
python -m venv venv

# 3. Kích hoạt môi trường ảo
# Đối với Windows PowerShell:
.\venv\Scripts\activate
# Đối với Linux / MacOS:
source venv/bin/activate
Bước 3: Chạy script cấu hình tự động (Setup Scripts)
Kohya_ss cung cấp các tập lệnh tự động nhận diện phần cứng và tải phiên bản PyTorch, Torchvision, xformers phù hợp nhất:
# Trên Windows:
.\setup.bat

# Trên Linux:
chmod +x setup.sh
./setup.sh
Trong quá trình chạy script, trình cài đặt sẽ hỏi bạn các câu hỏi cấu hình Accelerate (HuggingFace Accelerate Config). Chọn các thông số mặc định theo hướng dẫn sau:
- In which compute environment are you running? -> This machine
- Which type of machine are you using? -> No distributed training
- Do you want to run your training on CPU only? -> NO
- Do you wish to optimize your script with torch dynamo? -> NO
- Do you want to use DeepSpeed? -> NO
- What GPU(s) should be used for training? -> all
- Do you wish to use FP16 or BF16? -> fp16 (hoặc bf16 nếu dùng RTX 3000/4000 series)
Bước 4: Khởi động giao diện WebUI
Sau khi thiết lập hoàn tất, kích hoạt giao diện điều khiển bằng lệnh:
# Trên Windows:
.\gui.bat

# Trên Linux:
./gui.sh
Hệ thống sẽ khởi chạy server local tại đường dẫn: http://127.0.0.1:7860.
4. Chuẩn bị tập dữ liệu (Dataset Preparation) và Cấu hình tham số
Chất lượng mô hình LoRA đầu ra tuân thủ tuyệt đối nguyên lý “Garbage In, Garbage Out”. Chuẩn bị dữ liệu cẩn thận quyết định 80% độ hội tụ và độ sắc nét của hình ảnh sinh ra.
Quy tắc đặt tên thư mục và tính toán số bước lặp (Repeats)
Kohya_ss quản lý tập dữ liệu dựa trên cấu trúc đặt tên thư mục mẹ và thư mục con. Định dạng chuẩn thư mục chứa ảnh:
dataset_root/
└── img/
    ├── 10_alexander person/
    │   ├── img01.png
    │   ├── img01.txt
    │   ├── img02.jpg
    │   └── img02.txt
    └── 1_reg_person/ (Thư mục Regularization - tùy chọn cho Dreambooth)
Ý nghĩa cấu trúc tên 10_alexander person:
10: Số lượng Repeats (lặp lại). Mỗi hình ảnh trong thư mục này sẽ được đọc lặp lại 10 lần trong 1 epoch.alexander: Trigger word (từ kích hoạt đại diện cho chủ thể hoặc phong cách).person: Class word (lớp đối tượng cơ sở).
Công thức tính tổng số bước huấn luyện (Total Steps):
Total Steps = (Số lượng ảnh \times Số Repeats \times Số Epochs) / Batch SizeVí dụ thực tế: Bạn có 20 ảnh chất lượng cao, đặt repeat là 10, huấn luyện trong 10 epochs với Batch Size = 2. Tổng số bước sẽ là: (20 \times 10 \times 10) / 2 = 1000 steps. Đây là số bước tiêu chuẩn lý tưởng cho một LoRA nhân vật trên SD 1.5.
Gán nhãn mô tả (Captioning/Tagging)
Mỗi bức ảnh cần một tệp văn bản đi kèm cùng tên (ví dụ: img01.png đi kèm img01.txt). Bạn có thể sử dụng công cụ tích hợp trong tab Utilities > Captioning của Kohya_ss:
- WD14 Tagger: Tối ưu cho phong cách Anime, 2D minh họa và Danbooru tags.
- BLIP Captioning: Tạo câu văn miêu tả tự nhiên (Natural language), tối ưu cho ảnh tả thực (Photorealistic) hoặc SDXL.
Tương tự như cách bạn tối ưu từ khóa trong bài viết tại khóa học SEO miễn phí, việc gán nhãn caption đòi hỏi loại bỏ các từ dư thừa (noise), chỉ giữ lại các đặc điểm ngữ nghĩa then chốt để mô hình AI học đúng thuộc tính mà bạn muốn trừu tượng hóa.
Cấu hình các siêu tham số quan trọng (Hyperparameters)
Trong tab LoRA > Parameters, hãy chú ý các thông số sau:
- Network Rank (Dimension – r): Đại diện cho dung lượng biểu đạt của mô hình. Giá trị khuyến nghị:
32hoặc64đối với nhân vật;128đối với phong cách phức tạp hoặc SDXL. Rank càng cao thì kích thước file càng lớn và nguy cơ quá khớp (overfitting) càng tăng. - Network Alpha: Hệ số tỷ lệ. Một quy tắc thực nghiệm phổ biến là đặt
Alpha = Rank / 2hoặcAlpha = 1khi sử dụng các optimizer tương thích tự điều chỉnh tỷ lệ. - Learning Rate (LR): Tốc độ học toàn cục. Đối với AdamW8bit:
- UNet Learning Rate:
1e-4(0.0001) - Text Encoder Learning Rate:
5e-5(0.00005) – giúp mô hình ghi nhớ trigger word mà không phá hỏng từ điển ngôn ngữ gốc.
- UNet Learning Rate:
- LR Scheduler: Chọn
cosine_with_restartshoặccosineđể giảm dần tốc độ học khi tiến dần về điểm cực tiểu toàn cục. - Optimizer:
AdamW8bitlà lựa chọn cân bằng hoàn hảo giữa tốc độ và tiết kiệm VRAM. Nếu muốn tối ưu cao cấp hơn, bạn có thể thử nghiệmProdigyvới tính năng tự động tìm kiếm Learning Rate thích ứng (Adaptive Learning Rate).
5. Quy trình huấn luyện LoRA qua giao diện WebUI và dòng lệnh CLI
Huấn luyện thông qua giao diện đồ họa (GUI)
- Tại tab Source model: Chọn Model Output Type (Safetensors), Base Model (ví dụ:
v1-5-pruned-emaonly.safetensorshoặc model SDXL 1.0 base). - Tại tab Folders: Trỏ đường dẫn đến thư mục Image (chứa thư mục con dataset), Output (thư mục lưu model LoRA tạo thành), và Logging (ghi log Tensorboard). Đặt tên mô hình tại mục Model output name.
- Tại tab Training parameters: Nhập đầy đủ các thông số Rank, Alpha, Learning Rate, Batch size đã tính toán ở mục 4.
- Bật các cờ tối ưu hóa bộ nhớ: Tích chọn Memory efficient attention (hoặc xformers), tích chọn Cache latents và Cache latents to disk để tăng tốc độ lặp epoch gấp 3-4 lần.
- Nhấn nút Start Training và theo dõi tiến trình chạy trong cửa sổ Command Prompt/Terminal.
Huấn luyện nâng cao bằng dòng lệnh CLI
Khi triển khai trên máy chủ đám mây (Google Colab, RunPod, Vast.ai) không có màn hình hiển thị, bạn có thể gọi trực tiếp tập lệnh train_network.py với các đối số cụ thể:
accelerate launch --num_cpu_threads_per_process=2 "./sd-scripts/train_network.py" \
  --pretrained_model_name_or_path="/workspace/models/v1-5-pruned-emaonly.safetensors" \
  --train_data_dir="/workspace/dataset/img" \
  --output_dir="/workspace/output" \
  --logging_dir="/workspace/logs" \
  --output_name="my_character_lora_v1" \
  --resolution=512,512 \
  --train_batch_size=2 \
  --max_train_epochs=10 \
  --save_every_n_epochs=2 \
  --mixed_precision="fp16" \
  --save_precision="fp16" \
  --seed=42 \
  --learning_rate=1e-4 \
  --lr_scheduler="cosine" \
  --optimizer_type="AdamW8bit" \
  --network_module=networks.lora \
  --network_dim=32 \
  --network_alpha=16 \
  --xformers \
  --enable_bucket \
  --min_bucket_reso=256 \
  --max_bucket_reso=1024 \
  --cache_latents
6. Khắc phục các lỗi thường gặp trong quá trình Train LoRA
Trong quá trình làm việc với Kohya_ss, người dùng thường gặp phải các lỗi xung đột thư viện CUDA hoặc thiếu hụt bộ nhớ phần cứng. Dưới đây là giải pháp xử lý triệt để cho từng tình huống:
Lỗi 1: CUDA Out of Memory (OOM)
Triệu chứng: Tiến trình huấn luyện dừng đột ngột với thông báo torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate...
Biện pháp khắc phục:
- Bật tính năng Gradient Checkpointing: Kỹ thuật này tái tính toán các kích hoạt trong pha lan truyền ngược thay vì lưu toàn bộ trên VRAM, giảm hơn 30% bộ nhớ GPU tiêu hao.
- Giảm Batch Size xuống
1. - Bật Cache latents để đưa hình ảnh về không gian tiềm ẩn một lần duy nhất trước khi huấn luyện.
- Sử dụng độ phân giải chuẩn (Resolution: 512×512 cho SD 1.5; 1024×1024 cho SDXL).
- Bật cờ fp16 hoặc bf16 trong phần Mixed Precision.
Lỗi 2: Xformers không hoạt động hoặc không tương thích phiên bản PyTorch
Triệu chứng: Thông báo No module named 'xformers' hoặc xformers is not available.
Biện pháp khắc phục:
# Đảm bảo môi trường ảo venv đang được kích hoạt
pip uninstall -y xformers torch torchvision torchaudio

# Cài đặt phiên bản PyTorch và xformers đồng bộ chính xác:
pip install torch==2.1.2+cu118 torchvision==0.16.2+cu118 --extra-index-url https://download.pytorch.org/whl/cu118
pip install xformers==0.0.23.post1 --index-url https://download.pytorch.org/whl/cu118
Nếu GPU hỗ trợ kiến trúc mới (RTX 4000 series), bạn có thể thay thế xformers bằng SDPA (Scaled Dot-Product Attention) có sẵn trong PyTorch 2.0+ bằng cách thêm cờ --sdpa.
Lỗi 3: Bitsandbytes lỗi trên hệ điều hành Windows
Triệu chứng: Báo lỗi bitsandbytes not compiled with CUDA support hoặc CUDA SETUP: libcusparse.so not found khi gọi bộ tối ưu hóa AdamW8bit.
Biện pháp khắc phục:
Phiên bản bitsandbytes chính thức trên PyPI trước đây ưu tiên nền tảng Linux. Trên Windows, hãy gỡ bỏ bản cũ và cài đặt gói dựng sẵn chuyên dụng của cộng đồng:
pip uninstall -y bitsandbytes
pip install bitsandbytes-windows
# Hoặc với các phiên bản Kohya_ss mới nhất:
pip install bitsandbytes==0.43.0 --upgrade
7. Tổng kết
Kohya_ss đã thiết lập chuẩn mực công nghiệp cho việc huấn luyện mô hình cá nhân hóa trong hệ sinh thái Stable Diffusion. Bằng việc nắm vững các siêu tham số như Rank, Alpha, Learning Rate và xử lý linh hoạt cơ chế quản lý bộ nhớ của CUDA, bạn có thể tự tin tạo ra các tác phẩm nghệ thuật, sản phẩm thương mại hoặc bộ nhận diện thương hiệu tự động với chi phí tính toán tối thiểu.
Việc kết hợp kỹ năng huấn luyện trí tuệ nhân tạo hiện đại với tư duy tối ưu hóa công cụ tìm kiếm bài bản từ khóa học SEO miễn phí sẽ mở ra lợi thế cạnh tranh vượt trội cho doanh nghiệp số trong bối cảnh công nghệ phát triển thần tốc.