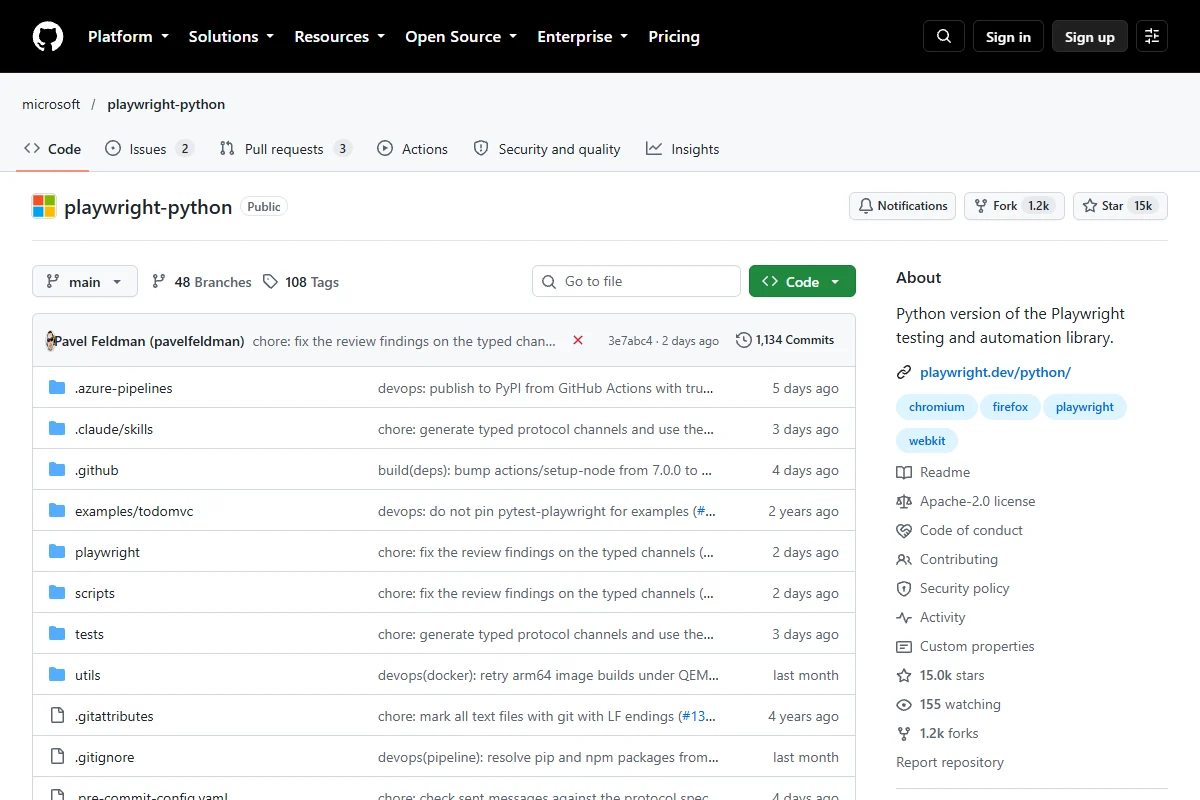
Tải mã nguồn Playwright Python trên GitHub
Sự trỗi dậy của các JavaScript framework như React, Vue, Angular và Next.js đã định hình lại kiến trúc web hiện đại qua mô hình Client-Side Rendering (CSR). Điều này đặt ra rào cản lớn cho Technical SEO: các crawler truyền thống chỉ nhận về khung HTML rỗng từ máy chủ và hoàn toàn bất lực trước nội dung sinh ra sau khi chạy mã client-side.
Dù Googlebot có Web Rendering Service (WRS), cơ chế lập chỉ mục hai đợt (two-wave indexing) vẫn gây ra độ trễ lớn và rủi ro rơi rụng dữ liệu nếu xảy ra lỗi hydration. Nhằm giúp chuyên gia SEO kiểm soát triệt để quá trình này, Microsoft đã phát triển Playwright-Python – framework tự động hóa headless browser hàng đầu hiện nay. Trong các giáo trình chuyên sâu như khóa học SEO miễn phí tại TPHCM, làm chủ kỹ thuật render DOM bằng Playwright là nền tảng bắt buộc để audit các hệ thống web phức tạp.
Nguyên lý hoạt động của Playwright trong Technical SEO
Playwright vượt trội hơn Selenium nhờ kiến trúc điều khiển hiện đại, cung cấp khả năng can thiệp trực tiếp vào nhân trình duyệt.
Đa nhân trình duyệt: Chromium, WebKit và Firefox
Playwright hỗ trợ đồng bộ cả 3 engine trình duyệt phổ biến nhất qua một giao diện lập trình duy nhất:
- Chromium: Đại diện cho Chrome và mô phỏng chính xác môi trường kết xuất của Googlebot Desktop lẫn Smartphone.
- WebKit: Nhân trình duyệt của Safari trên iOS/macOS, cho phép phát hiện lỗi hiển thị và bất tương thích script trên thiết bị Apple.
- Firefox (Gecko): Kiểm tra tính toàn vẹn của mã nguồn và độ nhất quán khi phân tích cấu trúc DOM.
Giao thức kết nối: CDP và WebSocket thay vì WebDriver
Khác với Selenium dùng HTTP WebDriver trung gian gây trễ, Playwright duy trì một kết nối WebSocket duy nhất với trình duyệt dựa trên Chrome DevTools Protocol (CDP). Kênh truyền hai chiều này cho phép lắng nghe sự kiện mạng, console log và thay đổi DOM tức thời theo thời gian thực mà không gặp độ trễ kết nối.
Xử lý Client-Side Rendering (CSR) và Single Page Applications (SPA)
Với các website SPA, URL thay đổi qua History API mà không nạp lại trang. Playwright sở hữu cơ chế auto-waiting thông minh: tự động đợi phần tử sẵn sàng, chờ mạng rảnh rỗi (network idle) trước khi bóc tách dữ liệu, giải quyết dứt điểm tình trạng crawl dữ liệu rỗng do JavaScript chưa nạp xong.
Kiểm tra DOM Hydration và Hydration Mismatch
Trên các nền tảng Universal Rendering (Next.js, Nuxt), lỗi Hydration Mismatch xảy ra khi cây DOM từ server không khớp với DOM do client tái tạo, khiến trình duyệt phải dựng lại từ đầu và có thể làm rơi rụng thẻ meta hoặc schema JSON-LD. Playwright cho phép lắng nghe console error để phát hiện chính xác vị trí xung đột hydration.
Yêu cầu hệ thống và môi trường cài đặt
Playwright Python vận hành độc lập, không yêu cầu cài đặt môi trường Node.js thủ công nhờ cơ chế Pythonic bindings tích hợp sẵn.
Phiên bản Python và Bindings
- Yêu cầu Python: Phiên bản 3.8 trở lên.
- Sync API: Phù hợp cho script audit độc lập, phân tích nhanh trên Jupyter Notebook.
- Async API: Sử dụng
asynciođể render đồng thời hàng chục trang với hiệu năng tối ưu.
Tương thích hệ điều hành và Dependencies Headless
Playwright hỗ trợ tốt trên Linux (Ubuntu 20.04+, Debian 11+), macOS và Windows. Khi chạy chế độ headless trên Linux server, thư viện cung cấp lệnh tự động cài đặt toàn bộ dependencies hệ thống (như libnss3, libatk, libgbm) chỉ bằng một thao tác.
Hướng dẫn cài đặt Playwright Python từng bước
Quy trình triển khai môi trường kiểm toán SEO với Playwright gồm các bước sau:
Bước 1: Thiết lập môi trường ảo Virtualenv
mkdir seo-playwright && cd seo-playwright
python -m venv venv
# Kích hoạt trên Linux/macOS: source venv/bin/activate
# Kích hoạt trên Windows: .\venv\Scripts\Activate.ps1
Bước 2: Cài đặt gói thư viện qua pip
pip install --upgrade pip
pip install playwright beautifulsoup4 requests
Bước 3: Tải Browser Binaries
# Tải nhân Chromium phục vụ audit Googlebot
playwright install chromium
# Tải dependencies hệ thống cho Linux
playwright install-deps chromium
Kịch bản thực tế: Audit Rendered HTML vs Raw HTML cho SEO
Kiểm toán sự chênh lệch (Delta) giữa mã HTML phản hồi ban đầu từ máy chủ (Raw HTML) và cây DOM hoàn chỉnh sau khi chạy JavaScript (Rendered HTML) là kỹ thuật quan trọng hàng đầu trong Technical SEO.
Ý nghĩa của việc so sánh Raw HTML và Rendered DOM
Nếu các thành phần SEO cốt lõi như thẻ <title>, thẻ meta canonical, hệ thống liên kết nội bộ hoặc dữ liệu có cấu trúc Schema chỉ xuất hiện sau khi client thực thi JS, website có nguy cơ bị bot tìm kiếm bỏ sót khi gặp giới hạn tài nguyên cào dữ liệu.
Script Python so sánh Raw HTML và Rendered HTML
import requests
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright

URL = "https://example.com"
UA = "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"

def get_raw_data(url):
    res = requests.get(url, headers={"User-Agent": UA}, timeout=15)
    soup = BeautifulSoup(res.text, "html.parser")
    title = soup.title.string.strip() if soup.title else ""
    links = {a["href"] for a in soup.find_all("a", href=True)}
    schemas = len(soup.find_all("script", type="application/ld+json"))
    return {"title": title, "links": links, "schemas": schemas}

def get_rendered_data(url):
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        page = browser.new_page(user_agent=UA)
        page.goto(url, wait_until="networkidle", timeout=30000)
        soup = BeautifulSoup(page.content(), "html.parser")
        title = soup.title.string.strip() if soup.title else ""
        links = {a["href"] for a in soup.find_all("a", href=True)}
        schemas = len(soup.find_all("script", type="application/ld+json"))
        browser.close()
        return {"title": title, "links": links, "schemas": schemas}

raw = get_raw_data(URL)
rendered = get_rendered_data(URL)
print(f"Title: Raw='{raw['title']}' | Rendered='{rendered['title']}'")
print(f"Links: Raw={len(raw['links'])} | Rendered={len(rendered['links'])}")
print(f"Schemas: Raw={raw['schemas']} | Rendered={rendered['schemas']}")

diff_links = rendered['links'] - raw['links']
if diff_links:
    print(f"⚠️ Phát hiện {len(diff_links)} liên kết nội bộ phụ thuộc vào JavaScript!")
Phát hiện liên kết nội bộ và Schema bị thiếu
Khi biến diff_links ghi nhận các liên kết quan trọng, điều này chứng minh website đang chèn link bằng sự kiện JavaScript thay vì thẻ <a href="..."> tiêu chuẩn. Điều này khiến Googlebot không thể khám phá các trang con trong đợt quét đầu tiên.
Chụp ảnh Full-page Screenshot và Đo lường Core Web Vitals (LCP, CLS)
Playwright cho phép đánh giá trải nghiệm trang thực tế thông qua việc chụp ảnh toàn màn hình và trích xuất chỉ số hiệu năng trực tiếp từ engine Chromium.
Chụp ảnh toàn trang (Full-page Screenshot) phục vụ Visual Diff
Khả năng tự động cuộn trang giúp bạn lưu lại toàn bộ giao diện để đối chiếu bố cục giữa các lần cập nhật mã nguồn:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page(viewport={"width": 1920, "height": 1080})
    page.goto("https://example.com", wait_until="networkidle")
    page.screenshot(path="full_audit.png", full_page=True)
    browser.close()
Giả lập Mobile Viewport và Đo lường LCP, CLS
Trong các dự án thiết kế website chuẩn SEO, việc kiểm soát điểm Cumulative Layout Shift (CLS) và Largest Contentful Paint (LCP) là điều kiện tiên quyết để tối ưu thứ hạng. Script dưới đây đo lường LCP và CLS theo chuẩn Performance API của Google:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    # Giả lập Googlebot Mobile Viewport
    context = browser.new_context(viewport={"width": 393, "height": 851}, is_mobile=True)
    page = context.new_page()
    page.add_init_script("""
        window.vitals = { lcp: 0, cls: 0 };
        new PerformanceObserver((list) => {
            const entries = list.getEntries();
            window.vitals.lcp = entries[entries.length - 1].startTime;
        }).observe({type: 'largest-contentful-paint', buffered: true});
        new PerformanceObserver((list) => {
            for (const e of list.getEntries()) {
                if (!e.hadRecentInput) window.vitals.cls += e.value;
            }
        }).observe({type: 'layout-shift', buffered: true});
    """)
    page.goto("https://example.com", wait_until="networkidle")
    page.wait_for_timeout(2000)
    vitals = page.evaluate("window.vitals")
    print(f"LCP: {vitals['lcp']:.2f} ms | CLS: {vitals['cls']:.4f}")
    browser.close()
Khắc phục các lỗi phổ biến khi tự động hóa thu thập dữ liệu
Khi triển khai crawl dữ liệu trên diện rộng, bạn cần áp dụng các giải pháp kỹ thuật sau để duy trì tính ổn định của hệ thống:
1. Xử lý Navigation Timeout
Tránh lạm dụng wait_until="networkidle" trên các trang có nhiều tracker quảng cáo hoạt động liên tục. Thay vào đó, hãy sử dụng wait_until="domcontentloaded" kết hợp với page.wait_for_selector("main, article, h1") để tiếp tục xử lý ngay khi khối nội dung chính sẵn sàng.
2. Cơ chế vượt tường lửa Bot Detection (Cloudflare, DataDome)
Để ngăn chặn việc bị WAF nhận diện là bot độc hại, hãy thêm cờ khởi động --disable-blink-features=AutomationControlled nhằm xóa thuộc tính navigator.webdriver, kết hợp thư viện playwright-stealth để che giấu dấu vân tay trình duyệt (WebGL, Canvas) và khai báo đầy đủ User-Agent thực tế.
3. Quản lý bộ nhớ tối ưu bằng BrowserContext
Thay vì khởi tạo lại phiên bản trình duyệt mới cho mỗi URL làm cạn kiệt RAM, hãy duy trì một đối tượng browser duy nhất và tạo các BrowserContext riêng biệt cho từng yêu cầu. Khi xử lý xong trang, lệnh context.close() sẽ giải phóng ngay bộ nhớ cache, cookie và cây DOM.
4. Khắc phục rò rỉ cờ Headless
Khai báo cờ --headless=new trong phiên bản Chromium hiện đại giúp trình duyệt chạy trên toàn bộ pipeline đồ họa hoàn chỉnh, loại bỏ hoàn toàn các sai lệch về font chữ và kích thước viewport mà các hệ thống bảo mật thường đối chiếu.
Tổng kết và Ứng dụng trong quy trình Dynamic Rendering
Playwright-Python mang lại cho chuyên gia SEO công cụ đắc lực để kiểm soát toàn bộ vòng đời hiển thị nội dung trên các nền tảng web hiện đại. Việc thấu hiểu sự khác biệt giữa Raw HTML và Rendered DOM giúp bạn chủ động phát hiện lỗi lập chỉ mục trước khi chúng ảnh hưởng tiêu cực đến thứ hạng tìm kiếm.
Đặc biệt, Playwright là thành phần cốt lõi trong giải pháp Dynamic Rendering: khi máy chủ phát hiện crawler tìm kiếm hoặc robot mạng xã hội, yêu cầu sẽ được chuyển tiếp qua Playwright để render sẵn toàn bộ cây DOM thành mã HTML tĩnh hoàn chỉnh. Cơ chế này vừa bảo đảm trải nghiệm tương tác mượt mà cho người dùng bằng công nghệ Single Page Application, vừa cung cấp tài liệu HTML đầy đủ dữ liệu cho công cụ tìm kiếm thu thập chỉ mục hiệu quả nhất.