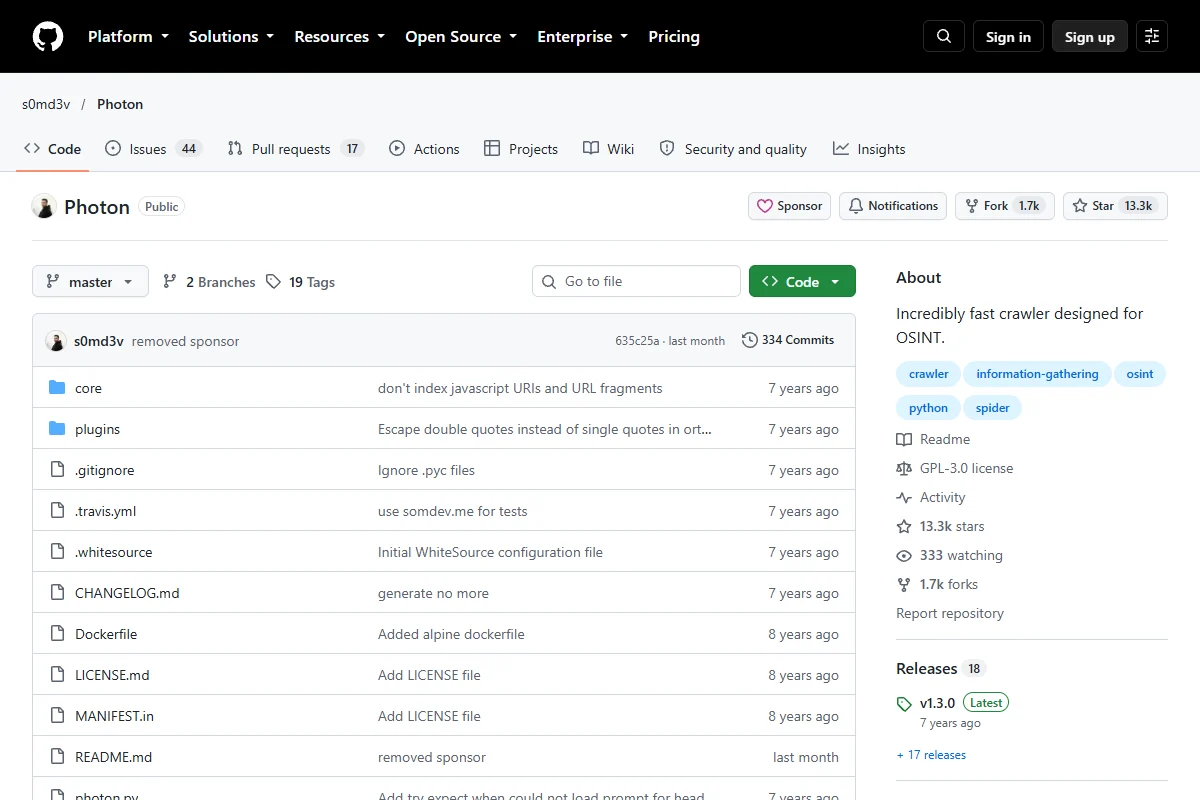
Tải mã nguồn Photon trên GitHub
Trong quy trình tối ưu hóa công cụ tìm kiếm kỹ thuật (Technical SEO) và bảo mật ứng dụng web, việc nắm bắt toàn diện cấu trúc liên kết, tài nguyên ngầm và các thông tin định danh (footprint) của một website là nhiệm vụ cốt lõi. Trong khi các công cụ thương mại quen thuộc như Screaming Frog, Ahrefs hay Sitebulb cung cấp giao diện đồ họa trực quan nhưng thường tiêu tốn tài nguyên và bị giới hạn tính năng tùy biến sâu, thì các kỹ sư SEO và chuyên gia an toàn thông tin thường tìm đến giải pháp mã nguồn mở linh hoạt và nhẹ nhàng hơn.
Một trong những crawler nổi tiếng nhất trong giới OSINT (Open Source Intelligence) và Web Reconnaissance chính là Photon do Somdev Sangwan phát triển. Được viết hoàn toàn bằng Python, Photon nổi bật nhờ tốc độ thu thập liên kết cực nhanh, cơ chế bóc tách thông tin tinh gọn và khả năng trích xuất dữ liệu không cấu trúc thông qua biểu thức chính quy (regular expressions). Bài viết này sẽ đi sâu vào phân tích kiến trúc, hướng dẫn triển khai thực tế và cách ứng dụng Photon vào hoạt động Technical SEO Audit chuyên sâu.
Giải thích nguyên lý hoạt động của Photon
Photon không đơn thuần là một trình tải trang web tuần tự. Nó được thiết kế với tư duy của một công cụ trinh sát mạng tốc độ cao, kết hợp giữa thuật toán duyệt đồ thị web (Graph Traversal) và cơ chế xử lý đa luồng (Multithreading).
Kiến trúc xử lý đa luồng (Multithreaded Architecture)
Mặc dù Python có rào cản Global Interpreter Lock (GIL), đối với các tác vụ I/O-bound như gửi yêu cầu HTTP và chờ phản hồi từ máy chủ web, mô hình đa luồng thông qua thư viện concurrent.futures hoặc threading đem lại hiệu năng vượt trội. Photon khởi tạo một thread pool cho phép gửi đồng thời hàng chục đến hàng trăm HTTP GET requests. Cơ chế bất đồng bộ nhẹ này giảm thiểu đáng kể thời gian nhàn rỗi (idle time) của CPU khi chờ TCP handshake và TTFB (Time to First Byte) từ server mục tiêu, giúp tốc độ quét có thể đạt hàng trăm URL mỗi giây nếu băng thông và máy chủ đáp ứng tốt.
Trích xuất và phân loại URL nội bộ và ngoại bộ
Trong quá trình phân tích cú pháp mã nguồn HTML nhận về, Photon sử dụng các thuật toán bóc tách siêu liên kết thông qua regex được tinh chỉnh cao cấp thay vì dựng đầy đủ DOM tree cồng kềnh. Công cụ tự động phân nhóm các liên kết tìm thấy thành các danh mục riêng biệt:
- Internal Links: Tất cả các liên kết có hostname trùng khớp hoặc thuộc subdomain của tên miền mục tiêu. Đây là nền tảng phục vụ phân tích kiến trúc liên kết nội bộ (Internal Linking Architecture).
- External Links: Các liên kết trỏ ra các tên miền khác, hỗ trợ kiểm tra liên kết ra ngoài (Outbound Links) và phát hiện backlink rò rỉ hoặc liên kết hỏng (Broken External Links).
- Scripts & Assets: Các đường dẫn chứa tài nguyên JavaScript (
.js), CSS (.css), hình ảnh, phông chữ. - Endpoints with Parameters: Các URL có chứa query string (ví dụ:
?id=123&category=tech), cực kỳ quan trọng cho việc phân tích các tham số trùng lặp gây hao tổn ngân sách thu thập thông tin (Crawl Budget).
Regex Pattern Matching cho dữ liệu nhạy cảm và tệp tin
Khác biệt lớn nhất giữa Photon và các crawler SEO thông thường là khả năng quét nội dung sâu bằng Regular Expressions chuyên biệt. Trong quá trình duyệt tài liệu, Photon liên tục đối soát văn bản với các biểu thức chính quy định sẵn nhằm trích xuất:
- Địa chỉ Email: Thu thập toàn bộ email xuất hiện trên trang phục vụ audit thông tin liên hệ hoặc kiểm tra rò rỉ thông tin nhân sự.
- Tài khoản mạng xã hội: Nhận diện liên kết tới Facebook, Twitter/X, LinkedIn, GitHub, YouTube,… hỗ trợ rà soát SameAs Schema và cấu trúc tín hiệu mạng xã hội (Social Signals).
- Tệp tin đặc biệt: Lọc các định dạng tài liệu như PDF, DOCX, XLSX, XML, SQL, ZIP, ENV, LOG vô tình bị để ngỏ hoặc lập chỉ mục không mong muốn.
- Secret Keys & Tokens: Nhận diện các chuỗi API keys (AWS, Google Maps, Stripe) bị lập trình viên hardcode trong file JavaScript công khai.
Footprinting và Fingerprinting Website
Photon đồng thời thu thập các dấu hiệu nhận dạng (footprints) của máy chủ thông qua HTTP Response Headers. Các trường như Server, X-Powered-By, Content-Type, chứng chỉ SSL/TLS và mã phản hồi HTTP trạng thái (200, 301, 302, 403, 404, 500) được ghi nhận chi tiết, giúp người làm SEO kỹ thuật nắm bắt được hạ tầng proxy ngược, CDN (Cloudflare, Fastly), hay framework backend mà trang web đang sử dụng.
Đối với những ai đang theo học và thực hành tại các khóa học SEO miễn phí, việc kết hợp các công cụ tự động hóa dòng lệnh như Photon song song với kiến thức SEO tiêu chuẩn sẽ giúp bạn hình thành tư duy phân tích dữ liệu đa chiều và vượt trội hơn so với các phương pháp làm thủ công thông thường.
Yêu cầu hệ thống và môi trường vận hành
Photon được xây dựng dựa trên triết lý tối giản (minimalist), do đó yêu cầu tài nguyên phần cứng rất khiêm tốn nhưng đòi hỏi môi trường phần mềm chuẩn xác:
- Hệ điều hành: Hoàn toàn đa nền tảng, chạy mượt mà trên Linux (Ubuntu, Debian, Kali Linux, Arch), macOS và Windows (CMD, PowerShell hoặc WSL).
- Phiên bản Python: Yêu cầu Python 3.6 trở lên (khuyến nghị Python 3.9+ để tận dụng tối đa các cải tiến xử lý chuỗi và tối ưu bộ nhớ).
- Các thư viện phụ thuộc chủ chốt:
requests: Xử lý giao thức HTTP/1.1 với session pooling, cookie management và custom headers.urllib3: Quản lý kết nối mạng cấp thấp và SSL verification.- Thư viện chuẩn của Python:
re(Regex engine),concurrent.futures(quản lý ThreadPool),argparse(phân tích tham số CLI),json(xuất dữ liệu có cấu trúc).
- Tài nguyên phần cứng khuyến nghị: Tối thiểu 1 CPU core và 512MB RAM đối với các website dưới 10.000 URLs. Đối với các website thương mại điện tử lớn với hàng trăm nghìn URL, khuyến nghị cấp phát tối thiểu 2GB – 4GB RAM để lưu trữ hàng đợi URLs trong bộ nhớ đệm (RAM Queue).
Hướng dẫn cài đặt Photon thủ công từng bước
Để đảm bảo công cụ hoạt động ổn định và không xảy ra xung đột dependency với hệ thống máy tính của bạn, việc cài đặt thủ công qua môi trường ảo (virtual environment) là giải pháp tối ưu nhất.
Bước 1: Tải mã nguồn từ kho lưu trữ GitHub
Mở terminal (trên Linux/macOS) hoặc PowerShell (trên Windows) và sử dụng Git để nhân bản repository:
git clone https://github.com/s0md3v/Photon.git
cd Photon
Bước 2: Khởi tạo môi trường ảo Python (Khuyến nghị)
Sử dụng Virtual Environment giúp cô lập hoàn toàn các thư viện của Photon khỏi hệ điều hành máy chủ:
# Trên Linux / macOS
python3 -m venv venv
source venv/bin/activate

# Trên Windows PowerShell
python -m venv venv
.\venv\Scripts\Activate.ps1
Bước 3: Cài đặt các gói thư viện phụ thuộc
Cài đặt danh sách thư viện được liệt kê trong tệp tin requirements.txt:
pip install -r requirements.txtKiểm tra quá trình cài đặt bằng cách gọi lệnh trợ giúp:
python photon.py --helpNếu màn hình hiển thị bảng danh sách các cờ tùy chọn của Photon cùng banner chữ ASCII nghệ thuật, hệ thống của bạn đã sẵn sàng hoạt động.
Hướng dẫn sử dụng các tham số dòng lệnh quan trọng
Photon cung cấp một bộ tham số dòng lệnh (CLI flags) phong phú cho phép tùy biến sâu hành vi crawl theo từng mục đích nghiên cứu.
1. Khởi chạy quét cơ bản với tham số -u
Để tiến hành thu thập thông tin một website đơn giản nhất:
python photon.py -u https://example.comKhi lệnh hoàn tất, Photon sẽ tự động tạo một thư mục mang tên tên miền mục tiêu bên trong thư mục thực thi, lưu trữ các tệp văn bản thô phân loại theo từng nhóm dữ liệu.
2. Kiểm soát độ sâu thu thập dữ liệu với -l (Level/Depth)
Độ sâu của liên kết biểu thị khoảng cách số lần nhấp chuột từ trang chủ (Click Depth):
-l 1: Chỉ quét trang chỉ định ban đầu và trích xuất các liên kết xuất hiện trực tiếp trên trang đó.-l 2: Quét trang ban đầu và tiếp tục đào sâu thêm một cấp độ liên kết (mặc định của Photon).-l 3hoặc cao hơn: Đào sâu vào các tầng liên kết sâu hơn. Cần lưu ý giá trị này vì đồ thị web phát triển theo cấp số nhân có thể khiến thời gian quét kéo dài.
python photon.py -u https://example.com -l 33. Điều chỉnh số luồng song song với -t (Threads)
Mặc định Photon chạy với 2 luồng. Nếu bạn đang quét máy chủ của chính mình hoặc có băng thông tốt và muốn hoàn thành nhanh, hãy tăng số luồng lên 10, 20 hoặc 50:
python photon.py -u https://example.com -l 2 -t 304. Tải và sao lưu mã nguồn với cờ --clone
Cờ --clone cho phép Photon sao chép toàn bộ trang web mục tiêu về ổ cứng cục bộ theo cấu trúc thư mục thực tế. Đây là tính năng hữu ích khi bạn muốn thực hiện phân tích offline, đối soát mã nguồn HTML hoặc lưu trữ snapshot của đối thủ:
python photon.py -u https://example.com --clone5. Tùy biến User-Agent với --user-agent
Mặc định, các hệ thống tường lửa (WAF) có thể nhận diện User-Agent mặc định của Python-requests và chặn truy cập. Bạn có thể chỉ định User-Agent giả lập Googlebot để kiểm tra xem website có hiển thị nội dung khác nhau giữa người dùng và bot tìm kiếm hay không (Cloaking check):
python photon.py -u https://example.com --user-agent "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"6. Xuất báo cáo cấu trúc định dạng JSON với --export=json
Để dễ dàng tích hợp kết quả vào hệ thống cơ sở dữ liệu hoặc xử lý tiếp bằng Pandas, bạn có thể xuất dữ liệu dưới dạng tệp JSON hoàn chỉnh:
python photon.py -u https://example.com --export=json7. Bỏ qua các đường dẫn không cần thiết bằng Regular Expression với --exclude
Trong Technical SEO, các URL phân trang dài hoặc trang lọc sản phẩm có thể làm loãng dữ liệu crawl. Cờ --exclude nhận vào một biểu thức chính quy để loại trừ các URL khớp mẫu:
python photon.py -u https://example.com --exclude "/(cart|checkout|wp-admin|tag|page)/.*"Ứng dụng Photon trong Technical SEO & Audit Backlink
Mặc dù sinh ra từ cộng đồng bảo mật mạng, Photon lại sở hữu những đặc tính tuyệt vời phục vụ trực tiếp cho các bài toán tối ưu hóa công cụ tìm kiếm cấp cao.
1. Phát hiện tệp tin tài liệu ẩn và rò rỉ nội dung không mong muốn
Nhiều quản trị viên web vô tình tải lên các tài liệu nháp (PDF, DOCX) hoặc bản sao lưu dữ liệu (database backups .sql.gz) và gắn liên kết ở các trang con kín đáo. Các bot tìm kiếm của Google vẫn có thể tìm thấy và lập chỉ mục các tài liệu này, dẫn đến nguy cơ lộ bí mật kinh doanh hoặc sinh ra các trang nội dung rác (thin content). Bằng việc quét với Photon và kiểm tra danh mục files.txt tạo ra, bạn có thể nhanh chóng phát hiện toàn bộ các tệp tin tĩnh đang trỏ từ cấu trúc trang.
2. Rà soát cấu trúc liên kết mồ côi (Orphan Pages) và độ sâu liên kết
Bằng cách so sánh danh sách internal.txt mà Photon thu thập được thông qua việc cào liên kết tự nhiên từ trang chủ với toàn bộ danh sách URL trong sitemap.xml của trang web, bạn có thể tìm ra chính xác các trang “mồ côi” — những trang có trong Sitemap nhưng không nhận được bất kỳ liên kết nội bộ nào từ các trang khác. Trang mồ côi là nguyên nhân hàng đầu khiến PageRank nội bộ không được luân chuyển và trang khó đạt thứ hạng cao.
Kỹ năng phân tích cấu trúc liên kết nội bộ này cũng là một chuyên đề trọng tâm được hướng dẫn thực tế tại khóa học SEO miễn phí của Webnova, giúp học viên hiểu rõ cách dòng chảy sức mạnh (Link Equity) phân bổ xuyên suốt cây thư mục website.
3. Kiểm tra tham số URL và tối ưu hóa ngân sách thu thập thông tin (Crawl Budget)
Tệp tin fuzzable.txt hoặc danh sách URL chứa query strings do Photon xuất ra giúp người làm SEO rà soát các tham số phân loại (filtering), sắp xếp (sorting), hoặc theo dõi chiến dịch (tracking UTM tags). Nếu các URL này không được gắn thẻ Canonical chính xác hoặc không được cấu hình chặn thu thập dữ liệu trong tệp robots.txt, Googlebot sẽ lãng phí tài nguyên crawl vào hàng nghìn biến thể của cùng một trang nội dung, gây tổn hại nghiêm trọng đến tốc độ lập chỉ mục của các trang mới.
4. Rà soát liên kết gãy ra bên ngoài (Broken Outbound Links)
Khi các trang web bên ngoài mà bạn liên kết tới bị giải thể hoặc chuyển đổi chủ sở hữu, trang web của bạn có nguy cơ liên kết tới các trang web độc hại, cờ bạc hoặc trang lỗi 404. Tệp tin external.txt của Photon tổng hợp tất cả Outbound Links, cho phép bạn dễ dàng chạy một script Python kiểm tra mã phản hồi HTTP để gỡ bỏ hoặc cập nhật kịp thời các liên kết hỏng, bảo vệ độ uy tín (E-E-A-T) của website.
Khắc phục sự cố và lưu ý quan trọng khi vận hành
Khi vận hành crawler tốc độ cao như Photon trên các môi trường thực tế, bạn sẽ đối mặt với các rào cản kỹ thuật từ máy chủ và hạ tầng bảo mật. Dưới đây là những kinh nghiệm thực chiến giúp bạn xử lý các tình huống này:
1. Tránh bị chặn bởi hệ thống tường lửa WAF và Rate Limiting
Các giải pháp tường lửa ứng dụng web như Cloudflare, Sucuri hoặc ModSecurity sẽ lập tức kích hoạt cơ chế chặn IP (HTTP 403 Forbidden hoặc HTTP 429 Too Many Requests) nếu nhận thấy hàng chục yêu cầu gửi tới cùng lúc trong vòng một giây. Để khắc phục:
- Giảm số luồng: Hạ giá trị
-txuống mức an toàn (ví dụ:-t 2hoặc-t 4). - Thêm thời gian trễ giữa các request: Sử dụng cờ
-d(delay tính bằng giây) để tạo độ trễ nhân tạo, biến hành vi của bot trở nên tự nhiên hơn:python photon.py -u https://example.com -l 2 -t 2 -d 1.5 - Sử dụng Proxy xoay vòng: Sử dụng cờ
--proxyhoặc kết hợp mạng Tor/SOCKS5 proxy để định tuyến luồng dữ liệu thông qua các địa chỉ IP phân tán.
2. Xử lý timeout và nghẽn bộ nhớ khi quét website quy mô lớn
Với các website có hàng trăm nghìn URL hoặc các vòng lặp liên kết vô tận (Spider Traps – ví dụ như lịch ngày tháng, bộ lọc nhiều tầng), Photon có thể bị treo hoặc đầy bộ nhớ RAM nếu bạn đặt cờ -l quá lớn. Hãy luôn đặt cờ giới hạn độ sâu (depth) tối đa là 2 hoặc 3 trong lượt chạy đầu tiên, kết hợp với bộ lọc --exclude để chặn các thư mục phân trang vô hạn trước khi mở rộng phạm vi quét.
3. Phân tích kết quả sau khi hoàn thành
Sau khi quá trình crawl kết thúc, hãy điều hướng vào thư mục kết quả. Cấu trúc thư mục trả về sẽ bao gồm:
internal.txt: Tất cả liên kết nội bộ phục vụ rà soát kiến trúc URL và internal link.external.txt: Danh sách liên kết ra ngoài.files.txt: Các file tài liệu, media, nén được phát hiện.emails.txt: Địa chỉ email bóc tách được.scripts.txt: Các file JavaScript được nạp trên trang.custom.txt: Kết quả của các mẫu regex tự định nghĩa nếu có thiết lập.
Bạn có thể kết hợp các lệnh shell tiêu chuẩn trên Linux như sort -u internal.txt | wc -l để đếm nhanh số lượng URL duy nhất, hoặc chuyển đổi dữ liệu sang định dạng bảng tính CSV để xây dựng báo cáo kiểm toán kỹ thuật toàn diện cho khách hàng và doanh nghiệp.
Tổng kết
Photon là một công cụ mạnh mẽ, gọn nhẹ và đa năng, xóa nhòa ranh giới giữa kiểm thử an ninh mạng và Technical SEO. Bằng cách kết hợp linh hoạt cơ chế đa luồng, lọc regex chính xác và khả năng trích xuất dữ liệu không cấu trúc, Photon giúp các kỹ sư SEO nhanh chóng nhìn thấu mọi ngóc ngách của một website mà không cần phụ thuộc hoàn toàn vào các phần mềm thương mại đắt đỏ. Hãy làm chủ công cụ mã nguồn mở này để nâng cao hiệu suất làm việc và giải quyết triệt để các bài toán kỹ thuật phức tạp trên website của bạn.