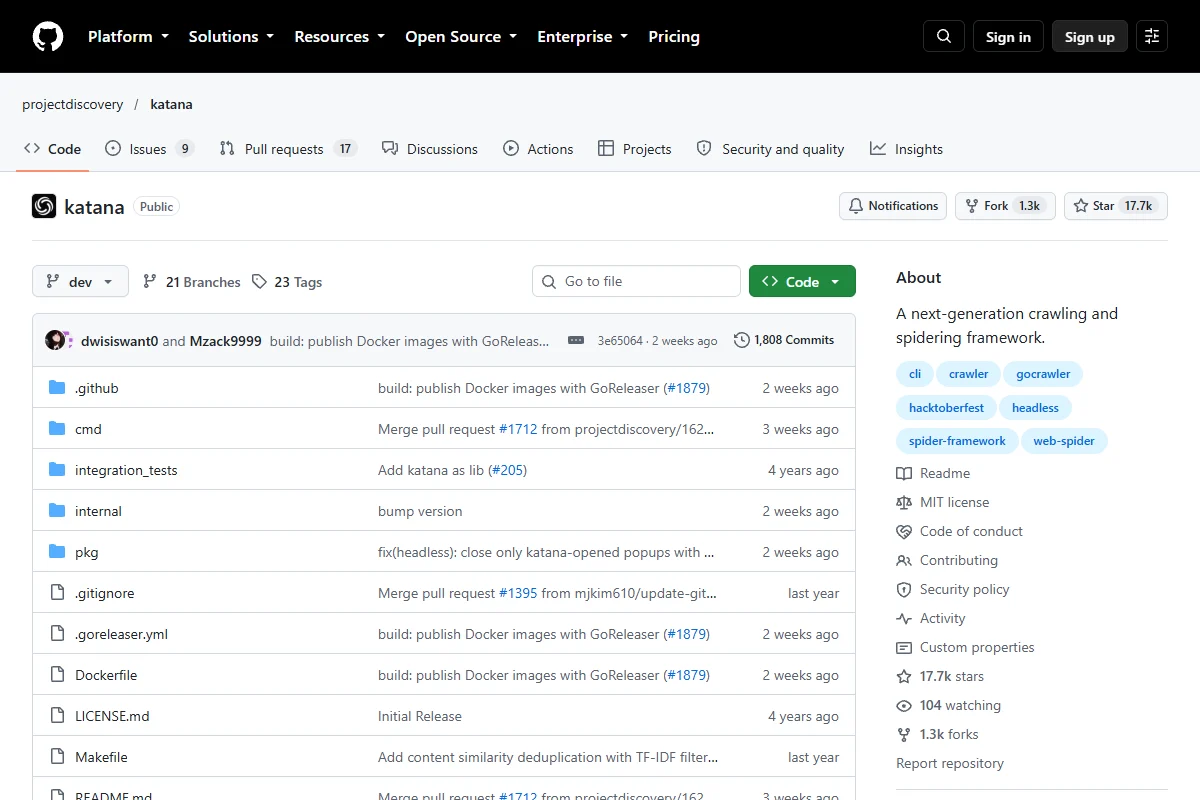
Tải mã nguồn Katana trên GitHub
Trong bối cảnh kiến trúc web hiện đại ngày càng chuyển dịch mạnh mẽ sang Single Page Applications (SPA), Serverless và client-side rendering (CSR) dựa trên các framework như React, Vue, Next.js hay Angular, việc thu thập dữ liệu web (web crawling) đối mặt với những thách thức chưa từng có. Các công cụ truyền thống vốn chỉ phân tích mã HTML tĩnh thường bỏ lọt các tài nguyên động, endpoint API ngầm định, và các luồng điều hướng được kích hoạt bởi JavaScript. Điều này gây thất thoát nghiêm trọng ngân sách thu thập dữ liệu (Crawl Budget), đồng thời khiến các chuyên gia Technical SEO bỏ sót những trang mồ côi (Orphan Pages) hoặc lỗi chỉ mục nghiêm trọng.
Để giải quyết bài toán hóc búa này, ProjectDiscovery – tổ chức nổi tiếng với hệ sinh thái công cụ bảo mật và tối ưu hạ tầng – đã phát triển Katana. Đây là một crawling engine thế hệ mới (Next-generation crawling engine) được lập trình hoàn toàn bằng ngôn ngữ Go. Với khả năng xử lý đồng thời siêu tốc, cơ chế thu thập dữ liệu kết hợp (hybrid pipeline) giữa HTTP parser chuẩn và trình duyệt không giao diện (Headless Chromium), Katana mở ra một tiêu chuẩn mới cho kiểm toán Technical SEO chuyên sâu và tối ưu hóa Crawl Budget ở quy mô hàng triệu URL.
Nguyên lý hoạt động và Kiến trúc của Katana Engine
Khác biệt cốt lõi giữa Katana và các web crawler truyền thống nằm ở kiến trúc lõi được xây dựng trên ngôn ngữ Go (Golang), tận dụng triệt để mô hình đồng thời (concurrency model) thông qua goroutine và worker pool linh hoạt.
1. Kiến trúc xử lý đồng thời dựa trên Go Concurrency
Katana vận hành cơ chế đa luồng phi khóa (lock-free concurrency) bằng cách phân bổ các tác vụ crawl thành các goroutine siêu nhẹ tiêu tốn chỉ vài kilobyte bộ nhớ, thay vì sử dụng native OS threads nặng nề. Engine này sử dụng cơ chế kênh (Go channels) để luân chuyển dữ liệu giữa các thành phần: URL Dispatcher, Downloader, Parser, và Normalizer. Mô hình này cho phép Katana xử lý hàng nghìn kết nối HTTP song song trong khi vẫn duy trì độ trễ thấp và mức tiêu thụ CPU/RAM tối thiểu.
2. Cơ chế thu thập lai: Standard Crawling song song Headless Rendering
Katana tích hợp kiến trúc đường ống kép (Hybrid Pipeline), mang lại sự cân bằng hoàn hảo giữa hiệu năng và độ bao phủ dữ liệu:
- Standard Crawling Pipeline: Sử dụng thư viện mạng hiệu năng cao fasthttp để gửi trực tiếp các yêu cầu HTTP thô, tải phản hồi và phân tích cây DOM. Cơ chế này đạt tốc độ hàng nghìn request/giây, lý tưởng cho các tài liệu HTML tĩnh, tệp XML Sitemap và các định dạng dữ liệu thuần.
- Headless Crawling Pipeline: Khi gặp các trang web động chứa nhiều logic JavaScript phức tạp, Katana tự động chuyển đổi hoặc kích hoạt Chrome DevTools Protocol (CDP) thông qua trình duyệt headless. Hệ thống sẽ kết xuất toàn bộ mã nguồn, thực thi các sự kiện DOM, render Virtual DOM và bắt trọn các request bất đồng bộ (XHR/Fetch) đang âm thầm tải tài nguyên.
3. Phân tích cú pháp JavaScript và khám phá Endpoint qua AST
Một điểm đột phá vượt trội của Katana là module phân tích cú pháp tĩnh dành cho JavaScript. Thay vì chỉ sử dụng các chuỗi biểu thức chính quy (Regex) thông thường vốn dễ sinh lỗi hoặc bỏ sót, Katana phân tách mã JavaScript thành cây cú pháp trừu tượng (Abstract Syntax Tree – AST). Từ cây AST này, engine trích xuất chính xác các đường dẫn router ngầm, tham số truy vấn, API endpoint được cấu hình trong các file bundle như Webpack, Vite, hay Rollup chunks mà các bot tìm kiếm thông thường của Googlebot có thể mất nhiều ngày mới giải mã hết.
4. Chuẩn hóa URL và khử trùng lặp (URL Normalization & Deduplication)
Để ngăn ngừa hiện tượng lãng phí Crawl Budget do bẫy liên kết (spider trap) hoặc các biến thể URL vô tận, Katana xây dựng pipeline chuẩn hóa cực kỳ nghiêm ngặt:
- Chuyển đổi toàn bộ scheme và host về chữ thường (lowercase canonicalization).
- Loại bỏ default port (:80, :443) và xử lý triệt để dấu gạch chéo cuối trang (trailing slashes).
- Sắp xếp lại thứ tự các tham số truy vấn (query parameters) theo bảng chữ cái.
- Loại bỏ các anchor hashtag (#) không ảnh hưởng tới định tuyến phía server.
- Tính toán giá trị băm (MurmurHash hoặc Bloom Filter) để lọc trùng lặp tức thì trong bộ nhớ đệm trước khi đưa URL vào hàng đợi xử lý tiếp theo.
Yêu cầu hệ thống và môi trường vận hành
Do được biên dịch trực tiếp thành một file nhị phân (binary) duy nhất, Katana có khả năng chạy độc lập mà không cần các runtime nặng nề như Python hay Node.js. Tuy nhiên, để tận dụng tối đa sức mạnh khi audit các website doanh nghiệp lớn, hệ thống cần đáp ứng các tiêu chí sau:
1. Yêu cầu phần cứng
- Chế độ Standard Crawling: Chỉ cần tối thiểu 1 vCPU và 512MB RAM. Katana có thể thu thập hàng chục nghìn trang web tĩnh trên một máy chủ ảo cỡ nhỏ (VPS cơ bản).
- Chế độ Headless Crawling: Yêu cầu tối thiểu 2 vCPU và 4GB RAM khả dụng (khuyến nghị 4 vCPU và 8GB RAM trở lên). Mỗi tab Chromium ngầm có thể ngốn từ 80MB đến 200MB RAM, do đó dung lượng bộ nhớ lớn là điều kiện tiên quyết để tránh sập tiến trình do Out-Of-Memory (OOM).
2. Yêu cầu phần mềm và phụ thuộc
- Golang Runtime: Go phiên bản 1.20 trở lên nếu bạn muốn build trực tiếp từ mã nguồn.
- Trình duyệt Chromium / Google Chrome: Cần được cài đặt sẵn trên máy chủ nếu chạy cờ
-headless(Katana hỗ trợ trỏ trực tiếp đến Chrome hệ thống qua cờ-system-chrome). - Docker Engine: Dành cho người dùng muốn cô lập hoàn toàn môi trường thực thi mà không cần cài đặt thêm bất kỳ thư viện ngoài nào.
Hướng dẫn cài đặt Katana thủ công từ mã nguồn
Người dùng có thể triển khai Katana linh hoạt thông qua ba phương pháp chính dưới đây:
Cách 1: Cài đặt trực tiếp qua Go Toolchain
Nếu máy trạm hoặc VPS của bạn đã có Go môi trường, chỉ cần thực thi một lệnh duy nhất để tải về và biên dịch bản phát hành mới nhất:
go install github.com/projectdiscovery/katana/cmd/katana@latestSau khi tiến trình hoàn tất, binary sẽ nằm trong thư mục $GOPATH/bin. Bạn cần đảm bảo thư mục này đã được thêm vào biến môi trường PATH của hệ điều hành.
Cách 2: Clone kho mã nguồn và Build Binary thủ công
Phương pháp này cho phép bạn tùy biến mã nguồn, tinh chỉnh các tham số kết nối hoặc nhúng thêm các bộ lọc chuyên biệt trước khi xuất xưởng binary:
# Sao chép repository từ GitHub
git clone https://github.com/projectdiscovery/katana.git

# Di chuyển vào thư mục dự án
cd katana/cmd/katana

# Biên dịch mã nguồn tối ưu kích thước
go build -ldflags="-s -w" -o katana

# Di chuyển binary vào thư mục thực thi toàn cục
sudo mv katana /usr/local/bin/

# Kiểm tra phiên bản hoạt động
katana -version
Cách 3: Triển khai qua Docker Container
Nếu bạn muốn tích hợp Katana vào pipeline CI/CD kiểm thử SEO tự động hoặc môi trường Kubernetes, Docker image chính thức từ ProjectDiscovery là giải pháp tiện lợi nhất:
docker pull projectdiscovery/katana:latest

# Khởi chạy một phiên crawl mẫu
docker run --rm projectdiscovery/katana:latest -u https://example.com -d 2
Hướng dẫn thu thập dữ liệu và phân tích Technical SEO bằng Katana CLI
Giao diện dòng lệnh (CLI) của Katana được thiết kế tinh giản nhưng cung cấp hệ thống cờ (flags) điều khiển cực kỳ mạnh mẽ, phục vụ sâu sắc cho các nhu cầu audit Technical SEO phức tạp.
1. Điều chỉnh độ sâu thu thập (-d) và kiểm soát tốc độ luồng (-c, -rl)
Đối với việc đánh giá cấu trúc liên kết nội bộ, việc giới hạn độ sâu thu thập (crawl depth) là vô cùng quan trọng để mô phỏng chính xác cách Googlebot duyệt qua website:
katana -u https://example.com -d 3 -c 20 -rl 50 -o crawl_results.txtTrong lệnh trên:
-u: Xác định URL gốc bắt đầu quá trình thu thập.-d 3: Giới hạn độ sâu duyệt qua tối đa 3 cấp bậc tính từ trang chủ (rất phù hợp để kiểm tra mức độ tiếp cận liên kết chuẩn Silo).-c 20: Số lượng goroutine worker chạy đồng thời song song (Concurrency).-rl 50: Giới hạn tối đa 50 requests mỗi giây (Rate Limit), bảo vệ hạ tầng máy chủ mục tiêu khỏi nguy cơ quá tải hay bị tường lửa chặn IP.
2. Kích hoạt chế độ Headless Rendering (-hl) cho các website SPA/PWA
Khi kiểm toán các nền tảng sử dụng JavaScript framework nặng như React, Vue, hay các nền tảng thương mại điện tử headless, các liên kết nội bộ chỉ xuất hiện sau khi mã script thực thi. Hãy sử dụng cờ -hl:
katana -u https://example.com -hl -system-chrome -timeout 15 -d 2 -jcCác cờ bổ trợ quan trọng:
-hl(headless): Bật chế độ duyệt web bằng trình duyệt Chromium ảo hóa.-system-chrome: Sử dụng trình duyệt Chrome cài đặt sẵn trên máy thay vì tải thêm bản Chromium độc lập.-jc(js-crawl): Phân tích cú pháp các tệp JavaScript bên ngoài để tìm kiếm liên kết ngầm định.
3. Định vị phạm vi thu thập dữ liệu (-cs, -f)
Để ngăn crawler đi lạc sang các tên miền bên ngoài (external domains) hoặc các trang subdomain không thuộc phạm vi audit, Katana hỗ trợ cơ chế Crawl Scope linh hoạt:
# Chỉ thu thập các URL nằm trong thư mục blog hoặc dịch vụ
katana -u https://example.com -cs "^https://example\.com/(blog|dich-vu)/" -f qurl
Cờ -f qurl (filter unique query url) giúp loại bỏ các URL trùng lặp cấu trúc chỉ khác biệt về giá trị tracking query như UTM tag hay Session ID, tiết kiệm tối đa thời gian crawl.
4. Xuất dữ liệu JSON có cấu trúc và kết hợp Pipeline (Piping)
Sức mạnh lớn nhất của Katana khi làm việc trên môi trường Linux/Unix là khả năng xuất định dạng JSON lines (JSONL) để kết hợp nhịp nhàng với các công cụ xử lý văn bản như jq, awk hoặc curl:
# Xuất toàn bộ dữ liệu metadata sang file JSON
katana -u https://example.com -j -o site_inventory.jsonl

# Trích xuất toàn bộ danh sách URL trả về mã trạng thái 200 bằng jq
cat site_inventory.jsonl | jq -r 'select(.response.status_code == 200) | .request.endpoint' | sort -u > live_urls.txt
Ứng dụng Katana trong Audit Crawl Budget và phát hiện Orphan Pages
Tối ưu hóa Crawl Budget và giải quyết triệt để vấn đề Orphan Pages (các trang không có bất kỳ liên kết nội bộ nào trỏ tới) là một trong những mục tiêu tối thượng của Technical SEO. Katana là vũ khí đắc lực để biến công việc phức tạp này thành một quy trình tự động hóa chính xác.
1. Cơ chế đối chiếu Crawl Map với XML Sitemap
Một trang web hoàn hảo về mặt cấu trúc đòi hỏi mọi trang có giá trị index trong XML Sitemap đều phải có đường dẫn nội bộ từ cấu trúc điều hướng website. Nếu trang chỉ nằm trong sitemap mà không thể tiếp cận qua click thông thường, trang đó rất dễ bị xếp vào diện Orphan Page và nhận ít PageRank nội bộ.
Quy trình kiểm tra được thực hiện đơn giản qua đoạn shell script dưới đây:
# Bước 1: Trích xuất toàn bộ danh sách URL từ XML Sitemap
curl -s https://example.com/sitemap.xml | grep -oP '(?<=<loc>)[^<]+' | sort -u > sitemap_urls.txt

# Bước 2: Thu thập toàn bộ liên kết nội bộ thực tế bằng Katana
katana -u https://example.com -d 5 -c 30 -silent | sort -u > crawled_urls.txt

# Bước 3: So sánh để tìm các trang mồ côi (chỉ có trong sitemap nhưng không crawl được)
comm -23 sitemap_urls.txt crawled_urls.txt > orphan_pages.txt

echo "Đã phát hiện $(wc -l < orphan_pages.txt) trang mồ côi cần tái cấu trúc liên kết nội bộ!"
Sau khi lọc ra danh sách orphan_pages.txt, doanh nghiệp cần kết hợp với đội ngũ phát triển để rà soát lại cấu trúc menu, breadcrumb, bài viết liên quan hoặc xem xét chiến lược thiết kế website chuẩn SEO nhằm xây dựng lại kiến trúc thông tin vững chắc ngay từ ban đầu.
2. Khám phá các Endpoint tiềm ẩn trong Bundle JavaScript
Trong các ứng dụng React hay Vue, nhiều đường dẫn landing page, danh mục sản phẩm, hoặc trang chiến dịch được hardcode trực tiếp dưới dạng route path trong file app.js hoặc các chunk mã hóa. Bằng cách kết hợp Katana với chế độ phân tích JS nâng cao (-jc), bạn có thể lôi ra toàn bộ các URL mà Googlebot có thể đã tìm thấy hoặc chưa kịp quét tới, từ đó đánh giá mức độ rò rỉ ngân sách thu thập vào các trang tài nguyên rác hoặc trang preview quản trị.
Khắc phục các lỗi thường gặp khi vận hành Katana
Trong quá trình triển khai quy mô lớn, chuyên viên kỹ thuật có thể gặp phải một số thách thức liên quan đến bảo mật máy chủ, tài nguyên phần cứng hoặc tiến trình hệ thống.
1. Hiện tượng bị Rate Limiting hoặc WAF chặn IP (403 Forbidden / 429 Too Many Requests)
Khi quét với tần suất quá cao, Katana có thể kích hoạt các bộ lọc bảo vệ của Cloudflare, Akamai hoặc AWS WAF. Để hạn chế tình trạng này, hãy áp dụng các kỹ thuật sau:
- Giới hạn tốc độ gửi yêu cầu: Sử dụng cờ
-rlđể khống chế từ 10 đến 30 requests/giây. - Tùy biến User-Agent: Sử dụng cờ
-H "User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"để mô phỏng trình duyệt người dùng thật. - Sử dụng Proxy xoay vòng: Katana hỗ trợ chuyển hướng lưu lượng qua danh sách proxy HTTP/SOCKS5 thông qua cờ
-proxy:katana -u https://example.com -proxy http://user:pass@proxyserver:8080
2. Xử lý tiến trình Headless Chromium Zombie (Treo CPU/RAM)
Khi sử dụng cờ -hl trên máy chủ Linux, nếu quá trình crawl gặp timeout đột ngột hoặc xảy ra lỗi phân giải trang, một số tiến trình Chromium có thể không tự giải phóng mà trở thành tiến trình ma (zombie process). Điều này dẫn đến tình trạng cạn kiệt bộ nhớ hệ thống sau vài giờ vận hành liên tục.
Để khắc phục triệt để:
- Cài đặt cờ
-timeout 10để tự động hủy các kết nối treo quá thời gian quy định. - Sử dụng lệnh kiểm tra và dọn dẹp tiến trình định kỳ bằng cronjob hoặc bash script:
# Tìm và tiêu diệt các tiến trình chrome bị cô lập
pkill -f "(chrome|chromium)" --signal SIGKILL
3. Hiện tượng tăng đột biến bộ nhớ (Memory Spikes) trên tên miền khổng lồ
Khi thu thập các website có hàng trăm nghìn URL, hàng đợi (queue) và bảng băm khử trùng trong RAM có thể phình to nhanh chóng. Giải pháp là chia nhỏ mục tiêu theo từng chuyên mục hoặc áp dụng cờ -depth có chọn lọc, kết hợp lưu trữ bộ đệm ra đĩa thay vì dồn toàn bộ vào RAM.
Tổng kết và So sánh Katana với các Crawler truyền thống
Để có cái nhìn tổng quan và lựa chọn công cụ phù hợp nhất cho từng kịch bản kiểm toán SEO, bảng đối chiếu dưới đây sẽ làm rõ sự khác biệt giữa Katana và các nền tảng phổ biến hiện nay:
| Tiêu chí so sánh | Katana (ProjectDiscovery) | Screaming Frog SEO Spider | Puppeteer / Playwright |
|---|---|---|---|
| Ngôn ngữ cốt lõi | Go (Golang binary siêu tốc) | Java (Desktop GUI) | Node.js / JavaScript runtime |
| Tốc độ thu thập | Cực nhanh (1000+ req/s ở chế độ standard) | Trung bình - Khá (bị giới hạn bởi JVM và GUI) | Chậm (nặng nề do render toàn bộ DOM) |
| Hỗ trợ Headless JS | Có (tích hợp hybrid thông minh) | Có (thông qua Chromium tích hợp) | Chuyên dụng cho Headless |
| Tự động hóa CI/CD | Hoàn hảo (CLI thuần, Docker, JSON piping) | Hạn chế (hỗ trợ CLI nhưng nặng tài nguyên) | Tốt nhưng đòi hỏi viết code tùy biến |
| Chi phí sử dụng | Mã nguồn mở miễn phí 100% | Có phí giấy phép thường niên | Mã nguồn mở miễn phí |
Katana không sinh ra để thay thế hoàn toàn các công cụ trực quan như Screaming Frog trong việc xuất báo cáo bảng tính trực tiếp cho khách hàng. Thay vào đó, nó là một giải pháp bổ trợ mang tính cách mạng cho các kỹ sư dữ liệu và chuyên gia Technical SEO cần xây dựng các hệ thống giám sát tự động, tối ưu hóa ngân sách thu thập ở quy mô triệu URL, hoặc rà soát cấu trúc web động với chi phí hạ tầng thấp nhất.
Nếu bạn muốn nâng cao kỹ năng xử lý dữ liệu web, làm chủ các công cụ crawl engine mã nguồn mở và xây dựng chiến lược kiến trúc liên kết chuyên nghiệp, bạn có thể tham khảo thêm các tài liệu thực chiến tại khóa học SEO miễn phí tại TPHCM để liên tục cập nhật các phương pháp kỹ thuật tiên tiến nhất trong ngành.