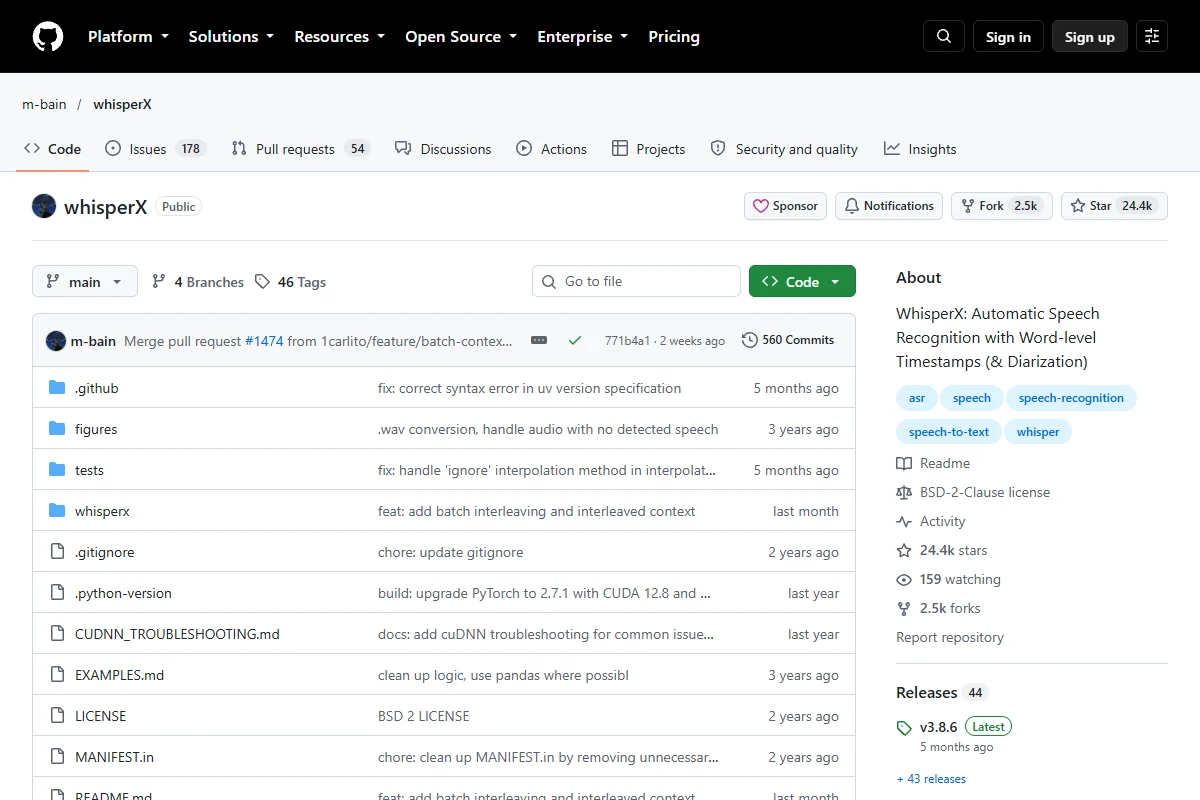
Trong kỷ nguyên video ngắn và nội dung đa phương tiện lên ngôi, việc tạo phụ đề tự động (Auto-subtitle) đã trở thành nhu cầu thiết yếu đối với các nhà sáng tạo nội dung, marketer và các lập trình viên AI. Tuy nhiên, các công cụ speech-to-text truyền thống thường gặp vấn đề về độ chính xác thời gian (timestamp) hoặc hoạt động chậm chạp khi xử lý video dài. Nhằm khắc phục những yếu điểm đó, WhisperX ra đời như một giải pháp đột phá, kết hợp sức mạnh nhận diện giọng nói của mô hình Whisper từ OpenAI với khả năng căn chỉnh từ ngữ cực kỳ chuẩn xác.
WhisperX không chỉ cải thiện tốc độ xử lý thông qua cơ chế nhận diện theo lô (batching) mà còn đảm bảo mỗi từ hiển thị trên màn hình khớp hoàn hảo với âm thanh nhờ vào công nghệ căn chỉnh VAD (Voice Activity Detection) và Phoneme Alignment. Đối với những ai đang tìm kiếm giải pháp tạo phụ đề video chuyên nghiệp, WhisperX chắc chắn là lựa chọn hàng đầu. Đặc biệt, nếu bạn đang xây dựng nội dung cho các chiến dịch Marketing và cần tối ưu hóa video trên nền tảng tìm kiếm, việc ứng dụng WhisperX kết hợp với những kiến thức từ Khóa học SEO miễn phí tại TPHCM sẽ mang lại hiệu quả vượt trội, giúp video của bạn dễ dàng leo top Google và YouTube.
Giải thích nguyên lý hoạt động
Để hiểu tại sao WhisperX lại có khả năng hoạt động nhanh và chính xác đến vậy, chúng ta cần đi sâu vào kiến trúc và luồng xử lý (pipeline) của hệ thống này. Quá trình xử lý âm thanh của WhisperX được chia thành ba giai đoạn chính, hoạt động tuần tự nhưng được tối ưu hóa ở mức cao nhất:
1. Voice Activity Detection (VAD)
Bước đầu tiên, WhisperX sử dụng một mô hình VAD chuyên dụng để phân tích toàn bộ file âm thanh và xác định chính xác những đoạn có tiếng người nói, loại bỏ khoảng lặng, tiếng ồn hoặc nhạc nền. Việc cắt âm thanh thành các đoạn nhỏ dựa trên VAD giúp mô hình Whisper không phải xử lý những đoạn âm thanh vô ích, tiết kiệm đáng kể tài nguyên tính toán và ngăn chặn hiện tượng “ảo giác” (hallucination) – lỗi phổ biến khi Whisper cố gắng dịch các đoạn không có tiếng nói.
2. Batch Transcription với Faster-Whisper
Khác với phiên bản Whisper nguyên bản xử lý âm thanh theo từng block 30 giây một cách tuần tự, WhisperX sử dụng backend faster-whisper hoặc CTranslate2 để thực hiện batch processing (xử lý song song nhiều đoạn âm thanh cùng lúc). Khi kết hợp với các GPU hiện đại có VRAM lớn, tốc độ phiên dịch có thể nhanh hơn gấp 10 đến 70 lần so với thời gian thực (real-time). Điều này có nghĩa là một video dài 1 tiếng có thể được dịch xong chỉ trong chưa đầy 1-2 phút.
3. Word-Level Phoneme Alignment
Sau khi có được văn bản thô từ Whisper, WhisperX tiếp tục đưa kết quả này qua một mô hình Wav2Vec2 hoặc các mô hình tương đương để thực hiện căn chỉnh ở cấp độ từ (word-level alignment). Mô hình căn chỉnh này đối chiếu âm vị (phonemes) trong văn bản với tín hiệu âm thanh gốc để xác định chính xác thời điểm bắt đầu (start) và kết thúc (end) của từng từ với độ sai số chỉ tính bằng mili-giây. Đây là tính năng “ăn tiền” nhất của WhisperX, giúp bạn tạo ra những video có phụ đề chạy từng chữ (karaoke style) cực kỳ bắt mắt.
Ngoài ra, WhisperX còn tích hợp module Speaker Diarization (Phân biệt người nói) dựa trên công nghệ của Pyannote. Module này cho phép gán nhãn chính xác giọng nói thuộc về ai (Speaker 1, Speaker 2…), rất hữu ích khi xử lý video podcast, phỏng vấn hoặc hội nghị có nhiều người tham gia.
Yêu cầu hệ thống
Do WhisperX sử dụng các mô hình học sâu (Deep Learning) tương đối nặng, bạn cần đảm bảo hệ thống phần cứng và phần mềm đáp ứng các yêu cầu tối thiểu sau để phần mềm hoạt động trơn tru:
Yêu cầu phần cứng
- GPU (Card đồ họa): NVIDIA GPU là bắt buộc để có tốc độ tốt nhất (hỗ trợ CUDA). VRAM tối thiểu 4GB cho mô hình
base/small, 8GB cho mô hìnhmedium, và 12GB+ cho mô hìnhlarge-v2/large-v3. Nếu không có GPU, bạn vẫn có thể chạy trên CPU nhưng tốc độ sẽ rất chậm. - RAM: Tối thiểu 16GB, khuyến nghị 32GB trở lên nếu bạn xử lý các file âm thanh dài hoặc kích hoạt tính năng Diarization.
- Ổ cứng: SSD với ít nhất 20GB dung lượng trống để lưu trữ các mô hình AI (Whisper models, alignment models, VAD models).
Yêu cầu phần mềm
- Hệ điều hành: Windows 10/11, Ubuntu 20.04/22.04 hoặc macOS (hỗ trợ Apple Silicon M1/M2 qua MPS).
- Python: Phiên bản 3.9, 3.10 hoặc 3.11 (Python 3.12 hiện chưa được hỗ trợ hoàn toàn với một số dependencies).
- CUDA Toolkit & cuDNN: Khuyến nghị CUDA 11.8 hoặc 12.1 cài đặt sẵn trên hệ thống nếu dùng card NVIDIA.
- Git: Dùng để clone mã nguồn từ GitHub.
- FFmpeg: Công cụ bắt buộc để trích xuất và xử lý âm thanh/video. Đảm bảo FFmpeg đã được thêm vào biến môi trường PATH của hệ thống.
Hướng dẫn cài đặt thủ công
Việc cài đặt WhisperX đòi hỏi bạn phải có chút kiến thức về dòng lệnh (Command Line). Dưới đây là các bước chi tiết để cài đặt WhisperX trên môi trường Windows hoặc Linux sử dụng Python Virtual Environment (venv).
Bước 1: Cài đặt FFmpeg
Trên Windows, bạn có thể cài đặt thông qua Scoop hoặc tải bản build từ Gyant: scoop install ffmpeg.
Trên Ubuntu/Debian, chạy lệnh: sudo apt update && sudo apt install ffmpeg.
Bước 2: Tạo môi trường ảo (Virtual Environment)
Khuyến khích sử dụng Anaconda hoặc venv để tránh xung đột thư viện với các dự án Python khác. Mở Terminal hoặc Command Prompt và chạy:
python -m venv whisperx-env
# Kích hoạt trên Windows:
whisperx-env\Scripts\activate
# Kích hoạt trên Linux/macOS:
source whisperx-env/bin/activate
Bước 3: Cài đặt PyTorch hỗ trợ CUDA
Bạn phải cài đặt phiên bản PyTorch tương thích với CUDA của máy tính. Ví dụ với CUDA 11.8:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118Bước 4: Clone repo và cài đặt WhisperX
Sau khi có PyTorch, chúng ta tiến hành tải mã nguồn và cài đặt thông qua pip:
git clone https://github.com/m-bain/whisperX.git
cd whisperX
pip install -e .
Lệnh pip install -e . sẽ cài đặt WhisperX ở chế độ edittable, giúp bạn dễ dàng cập nhật mã nguồn khi tác giả tung ra phiên bản mới bằng lệnh git pull.
Lưu ý: Nếu bạn gặp lỗi liên quan đến torchaudio hoặc C++ Build Tools trên Windows, hãy chắc chắn rằng bạn đã cài đặt Visual Studio C++ Build Tools.
Tải Model & Cấu hình
Khi bạn chạy WhisperX lần đầu tiên, hệ thống sẽ tự động tải các mô hình cần thiết từ Hugging Face và các nguồn lưu trữ khác. Tuy nhiên, bạn cần hiểu rõ về các mô hình này để tùy chỉnh cho phù hợp với cấu hình máy và nhu cầu của mình.
Các loại mô hình Whisper
tiny/base: Dung lượng nhỏ, tốc độ siêu nhanh nhưng độ chính xác không cao, đặc biệt với tiếng Việt.small/medium: Cân bằng tốt giữa tốc độ và độ chính xác. Đề xuất sử dụngmediumcho các dự án thông thường.large-v2/large-v3: Độ chính xác tuyệt đối, hỗ trợ đa ngôn ngữ cực tốt (kể cả những ngôn ngữ ít dữ liệu). Khuyến nghị sử dụng nếu bạn có GPU VRAM từ 8GB trở lên.
Cấu hình Hugging Face Token (Dành cho Diarization)
Nếu bạn muốn sử dụng tính năng phân biệt người nói (Speaker Diarization), bạn cần cung cấp một Access Token từ Hugging Face vì mô hình Pyannote yêu cầu chấp nhận điều khoản sử dụng:
- Truy cập Hugging Face và tạo tài khoản.
- Đi tới trang mô hình
pyannote/speaker-diarization-3.1và click đồng ý các điều khoản. - Vào Settings > Access Tokens và tạo một token mới (quyền Read).
- Khi chạy lệnh CLI, bạn cần thêm tham số
--hf_token YOUR_TOKEN.
Hướng dẫn tạo Video
WhisperX cung cấp giao diện dòng lệnh (CLI) vô cùng mạnh mẽ. Bạn không cần phải viết code Python phức tạp, chỉ cần truyền các tham số vào Terminal là đã có thể trích xuất phụ đề (file .srt hoặc .vtt) hoàn chỉnh.
Cú pháp cơ bản
Để trích xuất phụ đề từ một video có tên video_cua_ban.mp4 với mô hình large-v2, bạn chạy lệnh sau:
whisperx video_cua_ban.mp4 --model large-v2 --language vi --align_model WAV2VEC2_ASR_BASE_10K_VIGiải thích tham số:
--model large-v2: Chọn phiên bản Whisper.--language vi: Ép mô hình dịch theo ngôn ngữ tiếng Việt (vi). Nếu không để, mô hình sẽ tự động phát hiện ngôn ngữ.--output_format srt: Xuất file dạng SRT (mặc định xuất tất cả các định dạng: srt, vtt, json…).--compute_type float16: Sử dụng định dạng tính toán float16 để giảm dung lượng VRAM và tăng tốc độ xử lý mà không làm giảm đáng kể độ chính xác.
Sử dụng tính năng phân biệt người nói (Diarization)
Để xuất ra phụ đề kèm theo tên người nói, hãy thêm cấu hình sau:
whisperx video_cua_ban.mp4 --model medium --diarize --hf_token YOUR_HUGGINGFACE_TOKENWhisperX sẽ phân tích và gắn thẻ [SPEAKER_00], [SPEAKER_01] vào từng đoạn hội thoại, rất chuyên nghiệp cho các video phỏng vấn dài.
Chèn phụ đề vào Video
Sau khi có được file .srt, bạn có thể dễ dàng ghép cứng phụ đề vào video bằng FFmpeg hoặc chỉnh sửa video thủ công qua phần mềm Premiere Pro, CapCut. Ví dụ dùng FFmpeg:
ffmpeg -i video_cua_ban.mp4 -vf subtitles=video_cua_ban.srt output.mp4Việc đầu tư tạo phụ đề chuẩn cho video không chỉ nâng tầm chất lượng nội dung mà còn là một bước quan trọng trong quy trình SEO Video. Nếu bạn muốn hệ thống hoá kiến thức tối ưu công cụ tìm kiếm, hãy đăng ký ngay Khóa học SEO miễn phí tại TPHCM để hiểu rõ cách Google đánh giá và xếp hạng nội dung đa phương tiện.
Khắc phục lỗi thường gặp
Trong quá trình triển khai và sử dụng WhisperX, bạn có thể gặp một số lỗi kỹ thuật do môi trường hệ thống hoặc phần cứng. Dưới đây là những lỗi phổ biến và cách khắc phục chi tiết:
Lỗi “CUDA Out of Memory”
Đây là lỗi kinh điển khi VRAM của card đồ họa không đủ để nạp toàn bộ mô hình vào bộ nhớ. Biểu hiện là tiến trình đột ngột bị crash kèm thông báo RuntimeError: CUDA error: out of memory.
Cách khắc phục:
- Thêm tham số
--batch_sizevà đặt giá trị nhỏ hơn. Mặc định WhisperX sử dụng batch size lớn để tối đa hóa tốc độ. Hãy thử--batch_size 4hoặc--batch_size 2. - Sử dụng mô hình nhỏ hơn (ví dụ chuyển từ
large-v2xuốngmediumhoặcsmall). - Chắc chắn rằng bạn đã kích hoạt tính toán độ chính xác thấp bằng cờ
--compute_type float16hoặcint8.
Lỗi “FP16 is not supported on CPU”
Lỗi này xảy ra khi bạn chạy WhisperX trên CPU nhưng lại cố tình (hoặc mặc định) sử dụng tính toán Float16, điều mà hầu hết các CPU không hỗ trợ tốt hoặc module CTranslate2 từ chối thực thi.
Cách khắc phục: Đơn giản thêm cờ --compute_type int8 khi sử dụng máy không có GPU (hoặc chạy tham số --device cpu).
Lỗi tải Model từ Hugging Face thất bại (Connection Timeout)
Tại Việt Nam, đôi khi kết nối đến server của Hugging Face bị gián đoạn do nhà mạng hoặc đứt cáp quang. Lỗi hiển thị thường là requests.exceptions.ConnectionError.
Cách khắc phục:
- Sử dụng mạng riêng ảo (VPN) hoặc DNS Google/Cloudflare.
- Tải model thủ công (offline) từ Hugging Face về máy, sau đó trỏ đường dẫn trực tiếp (model_path) vào WhisperX.
Phụ đề bị lệch thời gian khi video quá dài
Dù WhisperX đã có module alignment cực tốt, nhưng ở những video bị lỗi metadata âm thanh hoặc có quá nhiều tiếng ồn phức tạp, việc căn chỉnh có thể bị trượt nhẹ (drift).
Cách khắc phục: Bạn có thể tinh chỉnh tham số VAD. Sử dụng --vad_onset và --vad_offset để điều chỉnh độ nhạy của bộ phát hiện giọng nói. Tăng vad_onset lên 0.6 hoặc 0.7 có thể giúp loại bỏ nhiễu và căn chỉnh từ chính xác hơn.
Tóm lại, WhisperX đang định hình lại tiêu chuẩn xử lý âm thanh và phụ đề cho ngành sáng tạo nội dung. Việc hiểu rõ nguyên lý hoạt động, cấu hình đúng và thành thạo CLI sẽ giúp bạn tự động hóa hàng loạt công việc tẻ nhạt. Và đừng quên, nội dung hay cần có chiến lược phân phối chuẩn SEO. Hãy trang bị thêm cho mình những kỹ năng digital marketing thiết yếu thông qua các chương trình đào tạo uy tín để tối đa hóa lợi nhuận từ những video do bạn sản xuất.
Với hướng dẫn chi tiết từ A-Z trên đây, hy vọng bạn đã có thể cài đặt và sử dụng thành thạo WhisperX, công cụ tạo AI Video siêu tốc, đưa quy trình sản xuất nội dung của bạn lên một tầm cao mới!