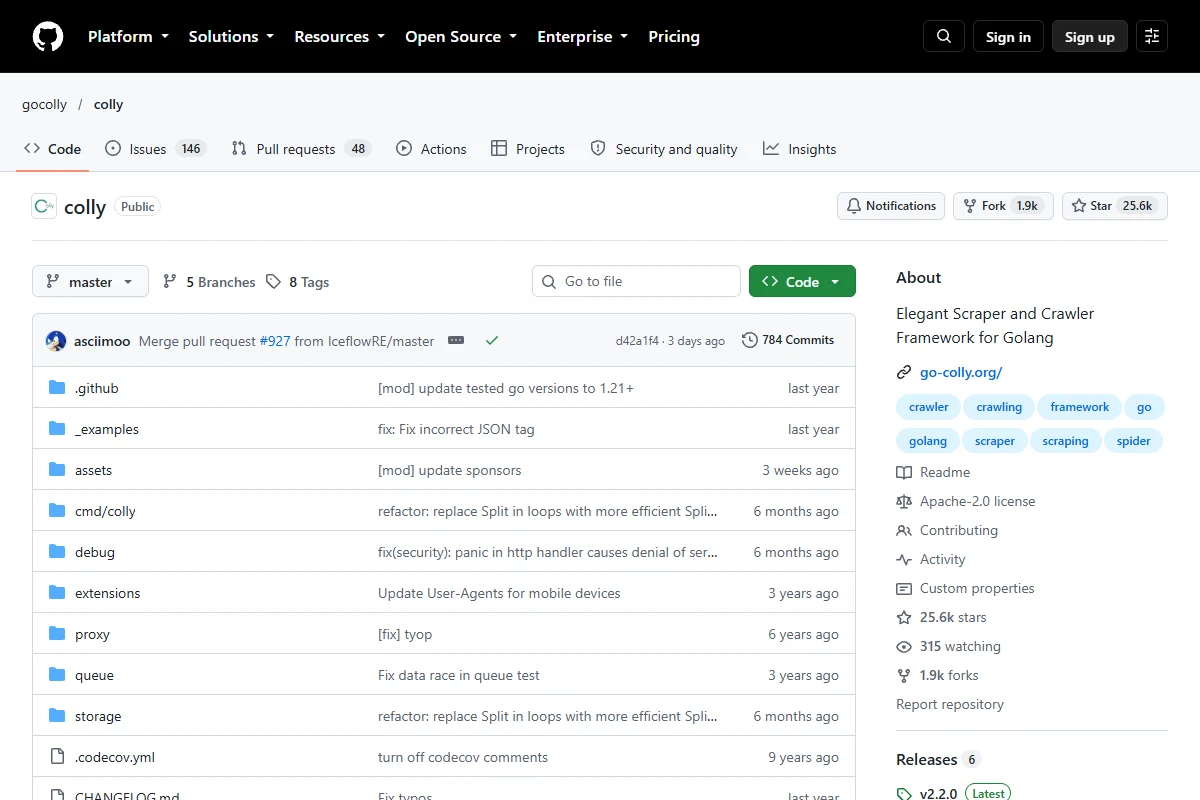
Tải mã nguồn Colly trên GitHub
Trong kỷ nguyên Big Data, thu thập dữ liệu web quy mô lớn phục vụ phân tích thị trường và kiểm toán Technical SEO đòi hỏi hệ thống crawler có tốc độ cao, độ trễ thấp và tiết kiệm bộ nhớ tối đa. Khi các công cụ trên Python hoặc Node.js gặp nút thắt cổ chai về hiệu năng và tiêu tốn nhiều RAM khi quét hàng triệu URL, Colly – framework cào dữ liệu viết bằng Golang – trở thành giải pháp hàng đầu. Nhờ cơ chế Goroutine đồng thời nguyên bản và cú pháp thanh lịch, Colly xử lý hàng ngàn request mỗi giây mà vẫn duy trì sự ổn định bền bỉ.
Kiến trúc và Cơ chế hoạt động của Colly
Kiến trúc cốt lõi của Colly xây dựng theo mô hình định hướng sự kiện (Event-driven Architecture), cho phép gắn callback xử lý dữ liệu tại từng giai đoạn trong vòng đời HTTP Request:
- OnRequest: Kích hoạt trước khi request được gửi; thích hợp để cấu hình HTTP Header, xoay vòng User-Agent hoặc nạp cookie phiên làm việc.
- OnResponse: Được gọi ngay khi nhận phản hồi thô từ web server, trước khi phân tích DOM; dùng để kiểm tra HTTP Status Code, kích thước phản hồi hoặc MIME Type.
- OnHTML: Bóc tách DOM bằng bộ phân tích CSS Selector mạnh mẽ dựa trên thư viện Goquery tương tự jQuery.
- OnError: Bắt lỗi tập trung nhằm xử lý gián đoạn kết nối, quá thời gian chờ (timeout) hoặc các mã lỗi HTTP 4xx, 5xx.
- OnScraped: Kích hoạt sau khi toàn bộ quy trình cào một URL hoàn thành, dùng để ghi log hoặc lưu trữ dữ liệu.
Về mô hình đồng thời, Colly vận hành trên các worker pools bất đồng bộ được điều phối trực tiếp bởi Goroutines. Mỗi Goroutine chỉ tiêu tốn 2KB đến 4KB bộ nhớ ban đầu, cho phép một tiến trình đơn lẻ quản lý hàng ngàn kết nối I/O song song mà không nghẽn tài nguyên. Bên cạnh hàng đợi bộ nhớ trong (In-memory queue) mặc định, Colly hỗ trợ tích hợp Redis Storage để mở rộng crawl phân tán (distributed crawling) trên nhiều cụm máy chủ.
Yêu cầu hệ thống và môi trường lập trình Golang
Để vận hành Colly trơn tru trên các hạ tầng crawl dữ liệu lớn, môi trường phát triển cần đáp ứng các tiêu chuẩn sau:
- Phiên bản Golang: Khuyến nghị Go 1.18 trở lên (tối ưu nhất từ Go 1.20+) nhằm tận dụng cơ chế quản lý bộ nhớ mềm
GOMEMLIMITvà bộ thu gom rác Garbage Collector cải tiến. - Hệ điều hành: Hoạt động tương thích trên Linux, macOS và Windows. Trong môi trường sản xuất, Linux x86_64 là lựa chọn số một nhờ cơ chế epoll tối ưu hóa I/O mạng tốc độ cao.
- Dấu ấn bộ nhớ tối thiểu: Nhờ ưu thế zero-overhead memory footprint của Golang, crawler chạy mượt mà trên máy chủ VPS cấu hình khiêm tốn (1 vCPU, 1GB RAM) mà vẫn thu thập hàng trăm URL mỗi giây.
Hướng dẫn cài đặt và khởi tạo dự án Go với Colly
Quy trình khởi tạo dự án Go và cài đặt Colly thực hiện nhanh chóng qua Go Modules tiêu chuẩn:
mkdir colly-seo-crawler
cd colly-seo-crawler
go mod init colly-seo-crawler
go get -u github.com/gocolly/colly/v2
Hệ thống tự động tải Colly cùng các gói phụ thuộc phân tích cú pháp HTML và ghi nhận vào tệp go.mod, go.sum.
Xây dựng Crawler Audit hàng triệu URL với Colly
Trong chiến dịch Technical SEO, kiểm toán cấu trúc on-page giúp rà soát mã phản hồi, thẻ canonical và tiêu đề trang. Để dữ liệu audit chuẩn xác, website mục tiêu cần tuân thủ cấu trúc tối ưu; bạn có thể tham khảo thêm về thiết kế website chuẩn SEO để hiểu cách tổ chức cây DOM thân thiện với bot thu thập thông tin.
Dưới đây là mã nguồn Go hoàn chỉnh: cấu hình đa luồng qua c.Limit, tuân thủ tệp robots.txt, xoay User-Agent ngẫu nhiên và bóc tách Canonical, H1, Meta Description cùng HTTP Status Code:
package main

import (
	"encoding/csv"
	"fmt"
	"log"
	"math/rand"
	"os"
	"strings"
	"sync"
	"time"

	"github.com/gocolly/colly/v2"
)

func main() {
	domain := "example.com"
	startURL := "https://" + domain

	csvFile, err := os.Create("seo_audit.csv")
	if err != nil {
		log.Fatalf("Lỗi tạo CSV: %v", err)
	}
	defer csvFile.Close()

	writer := csv.NewWriter(csvFile)
	defer writer.Flush()
	_ = writer.Write([]string{"URL", "Status", "Canonical", "H1", "Meta Description"})

	var mu sync.Mutex
	userAgents := []string{
		"Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)",
		"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/122.0.0.0 Safari/537.36",
	}

	c := colly.NewCollector(
		colly.AllowedDomains(domain, "www."+domain),
		colly.Async(true),
	)

	c.IgnoreRobotsTxt = false

	_ = c.Limit(&colly.LimitRule{
		DomainGlob:  "*" + domain + "*",
		Parallelism: 10,
		RandomDelay: 500 * time.Millisecond,
	})

	c.OnRequest(func(r *colly.Request) {
		r.Headers.Set("User-Agent", userAgents[rand.Intn(len(userAgents))])
	})

	c.OnResponse(func(r *colly.Response) {
		r.Ctx.Put("status", fmt.Sprintf("%d", r.StatusCode))
	})

	c.OnHTML("html", func(e *colly.HTMLElement) {
		u := e.Request.URL.String()
		st := e.Response.Ctx.Get("status")
		can := strings.TrimSpace(e.ChildAttr("link[rel='canonical']", "href"))
		h1 := strings.TrimSpace(e.ChildText("h1"))
		desc := strings.TrimSpace(e.ChildAttr("meta[name='description']", "content"))

		mu.Lock()
		_ = writer.Write([]string{u, st, can, h1, desc})
		mu.Unlock()

		e.ForEach("a[href]", func(_ int, el *colly.HTMLElement) {
			link := el.Request.AbsoluteURL(el.Attr("href"))
			if link != "" && !strings.Contains(link, "#") {
				_ = el.Request.Visit(link)
			}
		})
	})

	c.OnError(func(r *colly.Response, err error) {
		log.Printf("Lỗi %s: %v", r.Request.URL, err)
	})

	_ = c.Visit(startURL)
	c.Wait()
}
Tối ưu hiệu năng và Quản lý bộ nhớ khi crawl Big Data
Khi quét tập dữ liệu hàng triệu liên kết, crawler đối mặt với nguy cơ quá tải bộ nhớ và bị tường lửa chặn IP. Áp dụng các giải pháp kiến trúc sau sẽ giữ hệ thống hoạt động ổn định:
1. Thiết lập Rate Limiting và Điều phối Worker Pool
Gửi request quá nhanh dễ khiến máy chủ đích sập nguồn hoặc trả mã lỗi HTTP 429 Too Many Requests. Quy tắc c.Limit khống chế số Goroutine song song (Parallelism) từ 8 đến 16 worker và tạo độ trễ ngẫu nhiên (RandomDelay) nhằm mô phỏng lưu lượng truy cập tự nhiên.
2. Cơ chế Xoay vòng Proxy (Proxy Switching)
Để ngăn chặn IP bị chặn hàng loạt, Colly tích hợp sẵn bộ chuyển mạch Round-Robin proxy thông qua module colly/v2/proxy:
rp, err := proxy.RoundRobinProxySwitcher(
	"socks5://127.0.0.1:1080",
	"http://user:pass@proxy.node:8080",
)
if err == nil {
	c.SetProxyFunc(rp)
}
3. Phân tán trạng thái với Redis Storage Backend
Bộ nhớ InMemoryStorage tiêu tốn nhiều RAM khi lưu trữ hàng triệu URL đã ghé thăm. Kết nối Redis Storage giúp phân tán hàng đợi trên nhiều node máy chủ và tiết kiệm RAM:
import "github.com/gocolly/redisstorage"

storage := &redisstorage.Storage{
	Address:  "127.0.0.1:6379",
	Prefix:   "colly_queue",
}
_ = c.SetStorage(storage)
4. Tái sử dụng Buffer và Tối ưu Garbage Collection (Buffer Recycling)
Cấp phát liên tục các slice byte khi phân tích HTML lớn tạo áp lực lên Garbage Collector của Go. Hãy dùng sync.Pool để tái sử dụng buffer nhớ đệm và cấu hình GOMEMLIMIT=2GiB kết hợp GOGC=80 giúp thu gom rác kịp thời.
Để phát triển tư duy cấu trúc dữ liệu, giải thuật thu thập và ứng dụng phân tích web chuyên sâu, bạn có thể tham gia khóa học SEO miễn phí tại TPHCM nhằm trang bị kiến thức tự động hóa SEO thực chiến.
Khắc phục các lỗi thường gặp trong Golang Crawling
Trong quá trình cào dữ liệu quy mô lớn, việc xử lý lỗi mạng kịp thời giúp crawler không bị gián đoạn:
1. Lỗi Context Deadline Exceeded
Xuất hiện khi server mục tiêu phản hồi chậm vượt quá thời gian chờ của HTTP Client. Giải pháp là nâng timeout và duy trì kết nối keep-alive:
c.WithTransport(&http.Transport{
	DisableKeepAlives: false,
	IdleConnTimeout:   90 * time.Second,
})
c.SetRequestTimeout(60 * time.Second)
2. Lỗi TLS Handshake Timeout
Xảy ra do trễ mạng hoặc chứng chỉ SSL phức tạp khi đi qua proxy. Bạn cần điều chỉnh thông số Transport để kéo dài thời gian bắt tay bảo mật:
c.WithTransport(&http.Transport{
	TLSClientConfig:     &tls.Config{InsecureSkipVerify: true},
	TLSHandshakeTimeout: 15 * time.Second,
})
3. Vòng lặp chuyển hướng không kiểm soát (Unhandled Redirects)
Một số website cấu hình chuyển hướng HTTP 301/302 lặp vô tận. Thiết lập RedirectHandler giúp ngắt tiến trình nếu số lần chuyển hướng vượt giới hạn:
c.RedirectHandler = func(req *http.Request, via []*http.Request) error {
	if len(via) >= 5 {
		return fmt.Errorf("Dừng crawl: Quá 5 lần redirect")
	}
	return nil
}
4. Rò rỉ bộ nhớ do không đóng Response Body (Memory Leaks)
Trong các hàm xử lý tự viết hoặc khi tải file nhị phân lớn, nếu quên khai báo defer resp.Body.Close(), kết nối socket sẽ không được giải phóng, gây rò rỉ RAM và dẫn đến lỗi Out Of Memory (OOM).
Tổng kết và So sánh Colly với Scrapy Python
Bảng so sánh chi tiết dưới đây đối chiếu các tiêu chí kỹ thuật giữa Colly (Golang) và Scrapy (Python):
| Tiêu chí | Colly (Golang) | Scrapy (Python) |
|---|---|---|
| Ngôn ngữ | Golang (Biên dịch trực tiếp mã máy) | Python (Thông dịch runtime) |
| Mô hình đồng thời | Goroutines & Channels siêu nhẹ | Twisted Engine bất đồng bộ |
| Tốc độ cào | Rất cao (>1.000 requests/giây) | Trung bình (Bị ảnh hưởng bởi GIL) |
| Tiêu thụ RAM | Cực thấp (20MB – 80MB) | Cao khi hàng đợi mở rộng |
| Triển khai | Một file nhị phân duy nhất | Cần Python, pip và dependencies |
Nhìn chung, nếu dự án của bạn đòi hỏi hiệu năng thu thập tối đa, tiết kiệm tài nguyên máy chủ và dễ dàng triển khai trên môi trường Docker container nhỏ gọn, Colly là lựa chọn số một. Nắm vững Colly giúp bạn chủ động xây dựng các công cụ kiểm toán Technical SEO mạnh mẽ và mở rộng năng lực xử lý Big Data trong mọi bài toán thực tế.