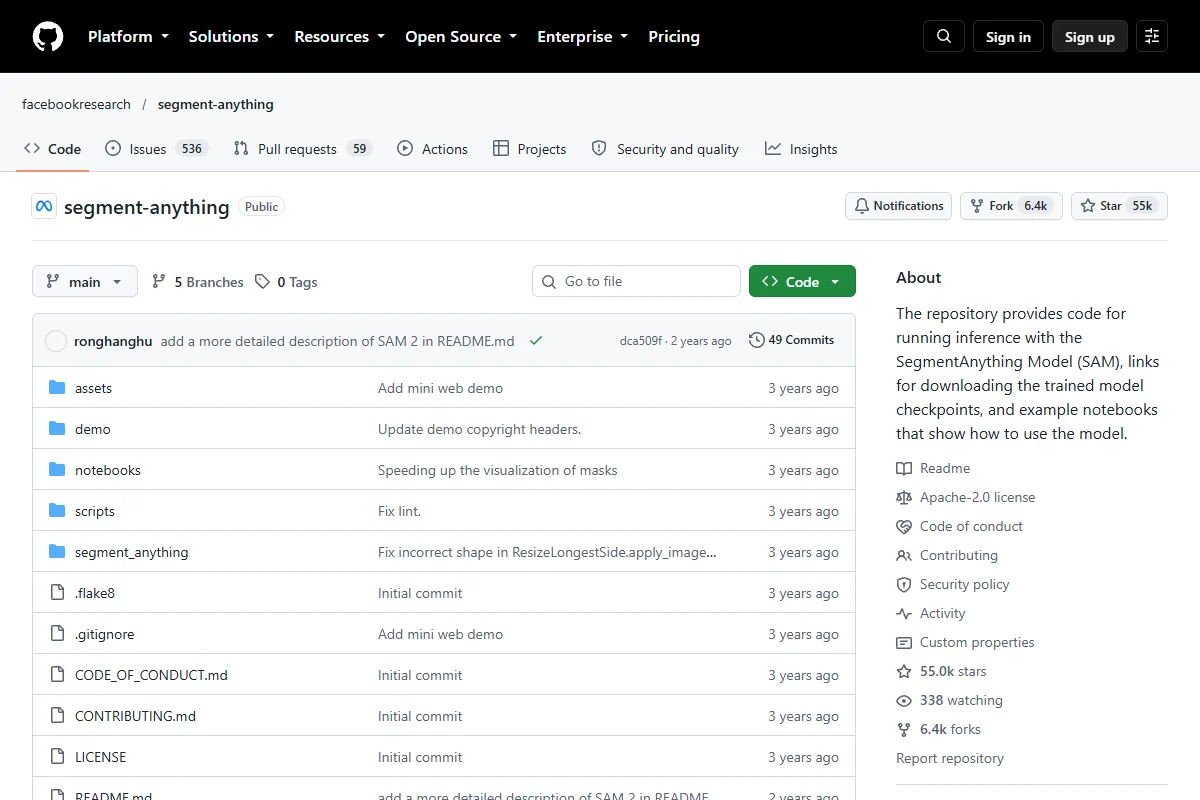
Tải mã nguồn Segment Anything trên GitHub
Segment Anything Model (SAM) do Meta AI (FAIR) phát triển và công bố là bước đột phá mang tính nền tảng trong lĩnh vực thị giác máy tính (Computer Vision), đặc biệt là phân vùng ảnh (Image Segmentation). Khác với các mô hình truyền thống chỉ có thể nhận diện hoặc cắt vật thể theo các nhãn phân lớp định sẵn (closed-set semantic segmentation), SAM sở hữu khả năng phân vùng không điểm dừng (zero-shot segmentation) trên bất kỳ hình ảnh nào mà không cần huấn luyện lại dữ liệu. Trong quy trình sản xuất nội dung số và tối ưu hóa hình ảnh chuẩn kỹ thuật, việc nắm bắt các công cụ AI tự động hóa như SAM mang lại lợi thế vượt trội. Điều này cũng tương tự như khi bạn tham gia khóa học SEO miễn phí để chuẩn hóa tư duy tự động hóa và xử lý tài nguyên media hiệu quả.
Giải thích nguyên lý hoạt động của Segment Anything (SAM)
Kiến trúc của Segment Anything được xây dựng dựa trên 3 khối thành phần cốt lõi: Image Encoder, Prompt Encoder và Mask Decoder. Sự phân tách này giúp mô hình đạt tốc độ xử lý theo thời gian thực (real-time) ở khâu tương tác người dùng, dù bộ mã hóa hình ảnh rất nặng.
1. Image Encoder (Bộ mã hóa hình ảnh)
Image Encoder sử dụng kiến trúc Vision Transformer (ViT) được tiền huấn luyện theo cơ chế masked autoencoder (MAE). Nhiệm vụ của encoder là xử lý một hình ảnh đầu vào có độ phân giải cao và chuyển đổi nó thành một biểu diễn nhúng không gian (image embedding) có kích thước cố định (thường là vector thu nhỏ 64×64 chiều sâu 256). Quá trình này tiêu tốn nhiều tài nguyên tính toán nhất, nhưng chỉ cần chạy duy nhất một lần cho mỗi bức ảnh.
2. Prompt Encoder (Bộ mã hóa chỉ dẫn)
SAM hỗ trợ hai nhóm chỉ dẫn (prompt) linh hoạt:
- Chỉ dẫn thưa thớt (Sparse prompts): Bao gồm tọa độ điểm (points – foreground/background), khung bao giới hạn (bounding boxes), hoặc văn bản gợi ý (text prompts). Điểm và khung bao được ánh xạ qua các positional encodings cộng với learned embeddings.
- Chỉ dẫn dày đặc (Dense prompts): Là mặt nạ nháp thô (rough masks) được xử lý qua các tầng tích chập (convolutions) và cộng trực tiếp vào biểu diễn của ảnh.
3. Mask Decoder (Bộ giải mã mặt nạ)
Mask Decoder có kích thước cực kỳ nhỏ gọn, áp dụng kiến trúc modified Transformer Decoder kết hợp cross-attention hai chiều (từ prompt sang image embedding và ngược lại). Sau khi tính toán tương quan, decoder chiếu các embedding sang ma trận mặt nạ phân giải cao thông qua transposed convolutional layers. Thời gian decoder tạo mặt nạ chỉ tính bằng mili-giây trên trình duyệt hoặc GPU, cho phép người dùng click chuột và nhận kết quả tức thì.
4. Cơ chế xử lý trường hợp mơ hồ (Ambiguity-aware)
Khi chỉ có một điểm click đơn lẻ, một vật thể có thể mang nhiều tầng nghĩa (ví dụ: click vào chiếc cúc áo có thể là cúc áo, áo sơ mi, hoặc người mặc áo). SAM giải quyết vấn đề này bằng cách dự đoán đồng thời 3 mặt nạ khác nhau ứng với các cấp độ chi tiết (sub-part, part, whole) cùng điểm số độ tin cậy (IoU score) tương ứng.
Yêu cầu hệ thống (Hardware & Software Specifications)
Để triển khai và thực thi SAM trên môi trường máy chủ cục bộ hoặc server Linux/Windows, bạn cần cấu hình phần cứng và phần mềm đáp ứng các tiêu chuẩn kỹ thuật sau:
1. Yêu cầu phần cứng
- GPU VRAM:
- ViT-B (Base): Tối thiểu 4 GB VRAM (Khuyến nghị 6 GB – 8 GB VRAM).
- ViT-L (Large): Tối thiểu 8 GB VRAM (Khuyến nghị 10 GB – 12 GB VRAM).
- ViT-H (Huge): Tối thiểu 12 GB VRAM (Khuyến nghị 16 GB – 24 GB VRAM đối với batch size lớn hoặc ảnh 4K).
- CPU & RAM: CPU tối thiểu 4 lõi 8 luồng, RAM hệ thống từ 16 GB trở lên để tải trọng số mô hình vào bộ nhớ đệm trước khi chuyển sang VRAM.
- Bộ nhớ lưu trữ: Tối thiểu 10 GB dung lượng trống để lưu mã nguồn và các file checkpoints (trọng số ViT-H chiếm ~2.6 GB).
2. Môi trường phần mềm
- Hệ điều hành: Linux (Ubuntu 20.04/22.04), Windows 10/11 (khuyên dùng WSL2 hoặc native Python 64-bit).
- Python: Phiên bản Python 3.8 đến Python 3.11.
- PyTorch: PyTorch >= 1.7 (khuyến nghị PyTorch 2.0+ hỗ trợ torch.compile và xFormers để tối ưu tốc độ tính toán).
- CUDA: CUDA Toolkit 11.7 hoặc 11.8/12.1 tương ứng với driver card đồ họa NVIDIA.
- Thư viện bổ trợ: Torchvision, OpenCV-Python, Matplotlib, NumPy.
Hướng dẫn cài đặt thủ công Segment Anything
Để đảm bảo không bị xung đột môi trường với các dự án machine learning khác, khuyến nghị khởi tạo một virtual environment (venv) hoặc Conda environment riêng biệt.
Bước 1: Khởi tạo môi trường ảo
# Tạo môi trường Conda với Python 3.10
conda create -n sam_env python=3.10 -y
conda activate sam_env

# Hoặc dùng venv tiêu chuẩn của Python:
# python -m venv sam_env
# source sam_env/bin/activate  # Trên Linux/macOS
# sam_env\Scripts\activate     # Trên Windows
Bước 2: Cài đặt PyTorch và Torchvision phù hợp với CUDA
Truy cập trang chủ PyTorch để lấy đúng lệnh cài đặt tương ứng với driver card mạng. Ví dụ cài đặt PyTorch hỗ trợ CUDA 11.8:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118Bước 3: Clone repository và cài đặt Segment Anything
Clone trực tiếp repository chính thức từ Meta Research và cài đặt ở chế độ editable hoặc package mode:
git clone https://github.com/facebookresearch/segment-anything.git
cd segment-anything

# Cài đặt SAM cùng các phụ thuộc
pip install -e .

# Cài đặt thêm các package hỗ trợ xử lý ảnh và hiển thị
pip install opencv-python matplotlib pycocotools
Tải Model Checkpoints & Cấu hình (ViT-H, ViT-L, ViT-B)
Meta phát hành ba phiên bản model checkpoint tương ứng với các biến thể của Vision Transformer. Tùy thuộc vào tài nguyên VRAM của card đồ họa, bạn có thể lựa chọn phiên bản phù hợp:
| Kiến trúc | Kích thước file | Số lượng tham số | Mục đích sử dụng |
|---|---|---|---|
| sam_vit_b | ~375 MB | 91M parameters | Tốc độ cao nhất, thích hợp GPU tầm trung hoặc chạy batch lớn |
| sam_vit_l | ~1.25 GB | 308M parameters | Cân bằng giữa tốc độ và độ chính xác phân vùng chi tiết |
| sam_vit_h | ~2.56 GB | 636M parameters | Chất lượng đường biên tối đa, thích hợp ảnh phức tạp, nhiều đối tượng nhỏ |
Sử dụng công cụ `wget` hoặc `curl` để tải các file checkpoint về thư mục dự án:
# Tạo thư mục chứa checkpoints
mkdir -p checkpoints

# Tải ViT-B checkpoint (Base)
wget -P checkpoints/ https://dl.fbaipublicfiles.com/segment_anything/sam_vit_b_01ec64.pth

# Tải ViT-L checkpoint (Large)
wget -P checkpoints/ https://dl.fbaipublicfiles.com/segment_anything/sam_vit_l_0b3195.pth

# Tải ViT-H checkpoint (Huge)
wget -P checkpoints/ https://dl.fbaipublicfiles.com/segment_anything/sam_vit_h_4b8939.pth
Hướng dẫn cắt tách vật thể tự động bằng Python script / CLI / Prompt điểm
Segment Anything cung cấp hai phương thức thực thi chính: tạo mặt nạ toàn bộ đối tượng tự động (Automatic Mask Generation) và trích xuất theo tọa độ prompt cụ thể (Predictor with Point/Box Prompts).
Phương pháp 1: Tách nền và cắt vật thể theo Prompt điểm (Point Prompt)
Kịch bản dưới đây sử dụng lớp `SamPredictor` để nạp ảnh, đưa vào tọa độ điểm đại diện cho đối tượng cần giữ lại (foreground), sau đó trích xuất vật thể và lưu thành file PNG có nền trong suốt (RGBA):
import cv2
import numpy as np
import torch
from segment_anything import sam_model_registry, SamPredictor

# 1. Khởi tạo mô hình
device = "cuda" if torch.cuda.is_available() else "cpu"
model_type = "vit_b"
checkpoint_path = "checkpoints/sam_vit_b_01ec64.pth"

sam = sam_model_registry[model_type](checkpoint=checkpoint_path)
sam.to(device=device)

predictor = SamPredictor(sam)

# 2. Đọc ảnh đầu vào
image_path = "input.jpg"
image_bgr = cv2.imread(image_path)
image_rgb = cv2.cvtColor(image_bgr, cv2.COLOR_BGR2RGB)

# 3. Tính toán image embedding (chỉ chạy 1 lần)
predictor.set_image(image_rgb)

# 4. Định nghĩa tọa độ điểm (X, Y) và nhãn (1: Foreground, 0: Background)
input_point = np.array([[500, 375]])
input_label = np.array([1])

# 5. Dự đoán mặt nạ
masks, scores, logits = predictor.predict(
    point_coords=input_point,
    point_labels=input_label,
    multimask_output=True,
)

# Chọn mặt nạ có điểm số tin cậy (IoU) cao nhất
best_mask_idx = np.argmax(scores)
mask = masks[best_mask_idx]

# 6. Tách vật thể và tạo ảnh trong suốt RGBA
h, w, _ = image_bgr.shape
rgba_image = np.zeros((h, w, 4), dtype=np.uint8)
rgba_image[:, :, :3] = image_bgr
rgba_image[:, :, 3] = (mask * 255).astype(np.uint8)

cv2.imwrite("output_cutout.png", rgba_image)
print(f"Đã xuất ảnh tách nền thành công với IoU score: {scores[best_mask_idx]:.4f}")
Phương pháp 2: Cắt toàn bộ vật thể tự động bằng SamAutomaticMaskGenerator
Nếu bạn muốn mô hình tự động quét và phân đoạn toàn bộ mọi đối tượng có trong hình ảnh (không cần người dùng chỉ định điểm), hãy sử dụng `SamAutomaticMaskGenerator`:
import cv2
import torch
from segment_anything import sam_model_registry, SamAutomaticMaskGenerator

device = "cuda" if torch.cuda.is_available() else "cpu"
model_type = "vit_b"
checkpoint_path = "checkpoints/sam_vit_b_01ec64.pth"

sam = sam_model_registry[model_type](checkpoint=checkpoint_path)
sam.to(device=device)

# Cấu hình bộ sinh mặt nạ tự động
mask_generator = SamAutomaticMaskGenerator(
    model=sam,
    points_per_side=32,
    pred_iou_thresh=0.86,
    stability_score_thresh=0.92,
    crop_n_layers=1,
    crop_n_points_downscale_factor=2,
    min_mask_region_area=100,  # Bỏ qua các chi tiết quá vụn
)

image_bgr = cv2.imread("input.jpg")
image_rgb = cv2.cvtColor(image_bgr, cv2.COLOR_BGR2RGB)

# Thực thi sinh toàn bộ mặt nạ
masks = mask_generator.generate(image_rgb)
print(f"Tổng số đối tượng được phát hiện và phân vùng: {len(masks)}")
Phương pháp 3: Chạy nhanh qua dòng lệnh (CLI)
Segment Anything tích hợp sẵn script thực thi thông qua terminal, cho phép bạn xử lý ảnh đơn lẻ hoặc toàn bộ thư mục chỉ với một dòng lệnh:
python scripts/amg.py \
    --checkpoint checkpoints/sam_vit_h_4b8939.pth \
    --model-type vit_h \
    --input images/input.jpg \
    --output output_masks/ \
    --device cuda
Thao tác tự động hóa quy trình cắt ảnh và xuất dữ liệu dạng hàng loạt này rất có ý nghĩa trong các chiến dịch digital marketing quy mô lớn. Để hiểu rõ cách kết hợp giữa các công cụ tự động hóa kỹ thuật với chiến lược phát triển website bền vững, bạn có thể tham khảo thêm tại khóa học SEO miễn phí được chia sẻ bởi đội ngũ kỹ thuật giàu kinh nghiệm.
Khắc phục các lỗi thường gặp khi triển khai Segment Anything
Trong quá trình thiết lập và vận hành SAM trên môi trường sản xuất thực tế, người phát triển thường gặp phải một số lỗi phổ biến sau:
1. Lỗi “CUDA out of memory” (OOM)
Triệu chứng: Khi nạp ảnh có độ phân giải lớn (4K trở lên) hoặc chạy `SamAutomaticMaskGenerator`, GPU báo lỗi `torch.cuda.OutOfMemoryError` và tiến trình bị dừng đột ngột.
Giải pháp xử lý:
- Chuyển đổi checkpoint: Thay thế `vit_h` bằng `vit_b` để giảm tải VRAM tiêu thụ từ 12 GB xuống dưới 4 GB.
- Sử dụng fp16 (Half Precision): Chuyển đổi mô hình sang chế độ tính toán dấu phẩy động 16-bit:
sam.to(device="cuda", dtype=torch.float16) - Giảm tham số `points_per_side`: Khi dùng `SamAutomaticMaskGenerator`, giảm `points_per_side` từ 32 xuống 16 hoặc 12 để giảm số lượng lưới prompt cần inference.
- Giải phóng bộ nhớ đệm: Thêm `torch.cuda.empty_cache()` sau mỗi chu kỳ xử lý ảnh.
2. Lỗi checkpoint không khớp kiến trúc (KeyError / Size mismatch)
Triệu chứng: Gặp thông báo lỗi dạng `RuntimeError: Error(s) in loading state_dict for VisionTransformer: Unexpected key(s) in state_dict` hoặc sai lệch kích thước tensor layers.
Nguyên nhân: Khởi tạo kiến trúc mô hình một đường nhưng nạp file trọng số một nẻo (ví dụ khai báo `model_type = “vit_b”` nhưng lại nạp file `sam_vit_h_4b8939.pth`).
Cách khắc phục: Luôn đảm bảo tên kiến trúc truyền vào `sam_model_registry` tương ứng chính xác với file checkpoint:
# ĐÚNG: vit_h đi kèm với sam_vit_h_4b8939.pth
sam = sam_model_registry["vit_h"](checkpoint="checkpoints/sam_vit_h_4b8939.pth")

# ĐÚNG: vit_b đi kèm với sam_vit_b_01ec64.pth
sam = sam_model_registry["vit_b"](checkpoint="checkpoints/sam_vit_b_01ec64.pth")
3. Thiếu thư viện hoặc lỗi tương thích `pycocotools` trên Windows
Trên hệ điều hành Windows, việc cài đặt `pycocotools` có thể phát sinh lỗi thiếu C++ Build Tools. Bạn có thể khắc phục bằng cách cài đặt bản pre-compiled build:
pip install pycocotools-windowsKết luận
Segment Anything (SAM) từ Meta AI là một bước tiến vượt bậc trong lĩnh vực thị giác máy tính, đem lại khả năng phân vùng hình ảnh không cần tinh chỉnh (zero-shot) với độ chính xác cao. Việc làm chủ kiến trúc, cách cài đặt và tối ưu hóa tài nguyên phần cứng sẽ giúp bạn ứng dụng hiệu quả công nghệ AI này vào việc bóc tách đối tượng, làm sạch dữ liệu hình ảnh và tự động hóa quy trình thiết kế số.